투자정보 웹의 프론트엔드·백엔드·웹디자인·홍보를 1인 개발로 진행했습니다. GPT-5, 6로 화면, 기능과 전용 AI 판단 모델을 개발하고 갱신과 Instagram 발행을 자동화했습니다.
1인 기획·개발·운영 2026년 ~ 현재 · 웹 개발·운영 / 모델 연구 Python · FastAPI · JavaScript · PyTorch
01개발 과정
왜 만들었는가
투자사의 보유 정보는 매일 공개됩니다. 하지만 일반 투자자가 원문을 찾아 전날과 비교하고, 시장의 변화까지 읽기에는 시간과 해석의 부담이 큽니다.
저는 ARK의 공개 보유 내역을 중심으로 수량·비중의 변화에 가격·뉴스를 연결했습니다. 사용자가 ‘오늘 어떤 정보를 알아야 하는가’를 판단할 수 있는 서비스를 만들고자 했습니다.
많은 시장 정보와 시계열의 종가 관계를 AI로 분석하고자 했습니다. 0~100점의 요약값에 해석과 기준일을 붙여, 사용자가 근거를 꼼꼼히 살펴 투자에 도움이 될 수 있게 했습니다.
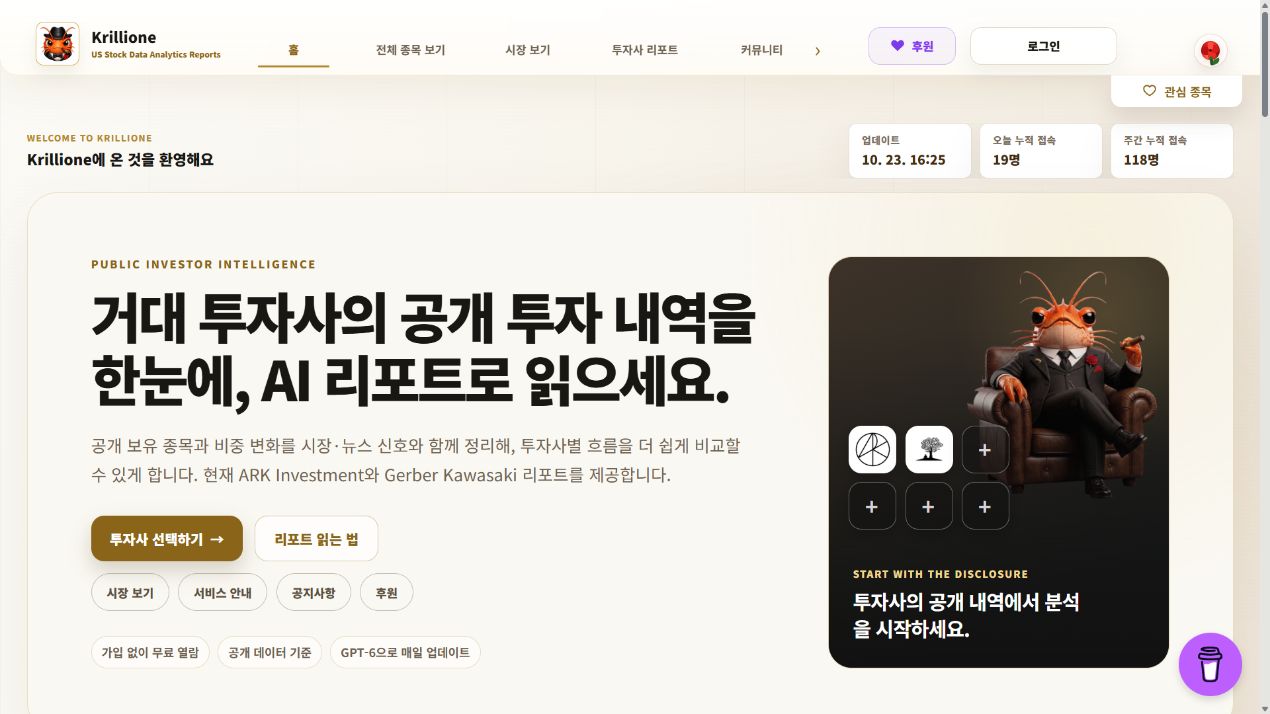
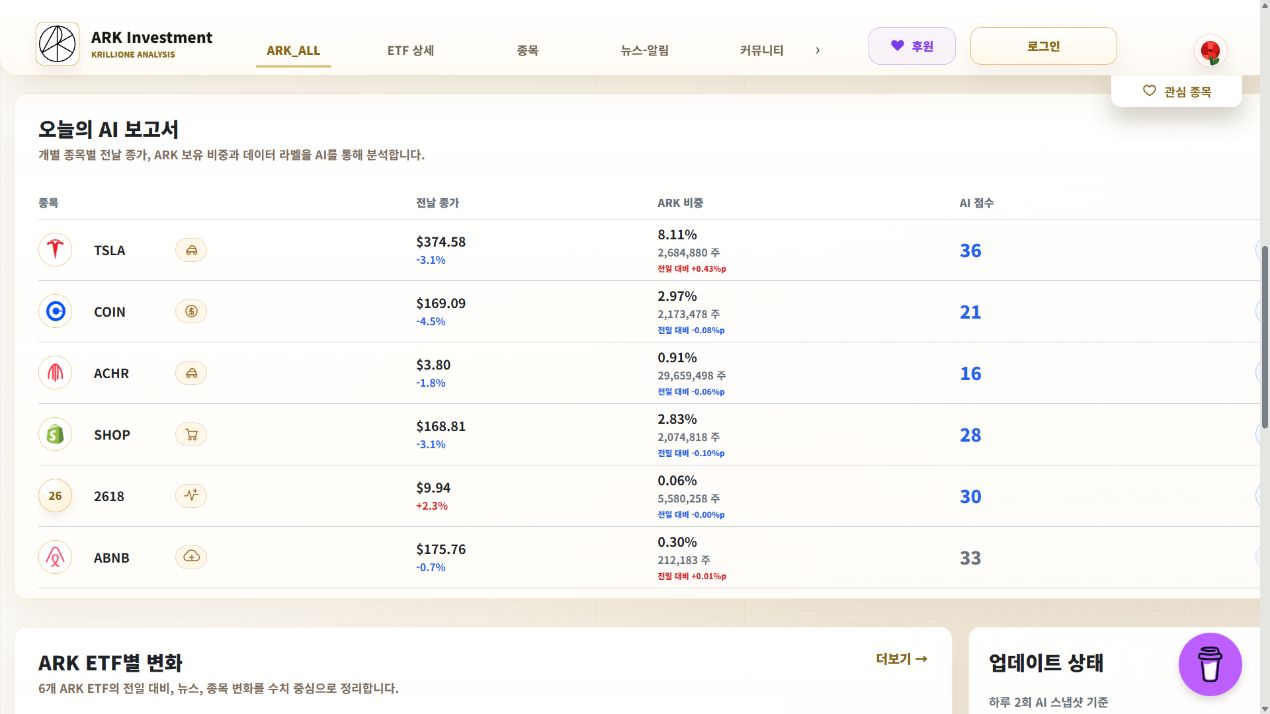
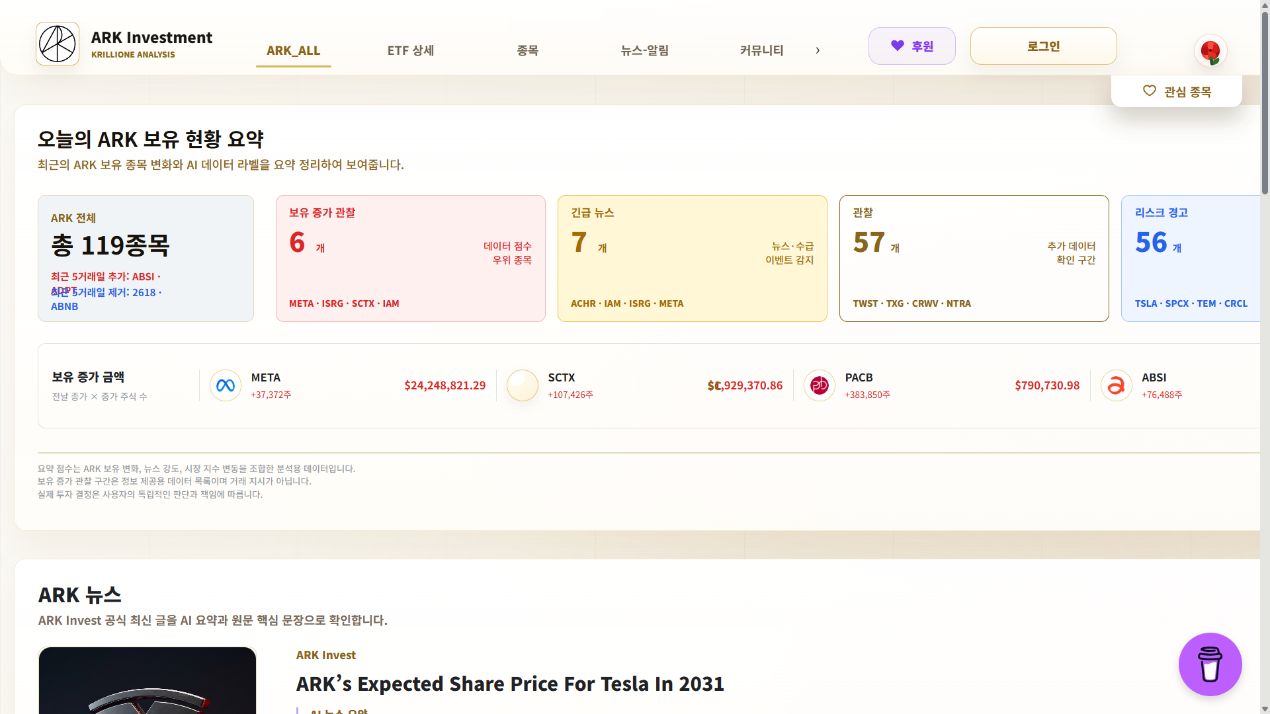
크릴리오네 홈
탐색 구조와 화면 설계
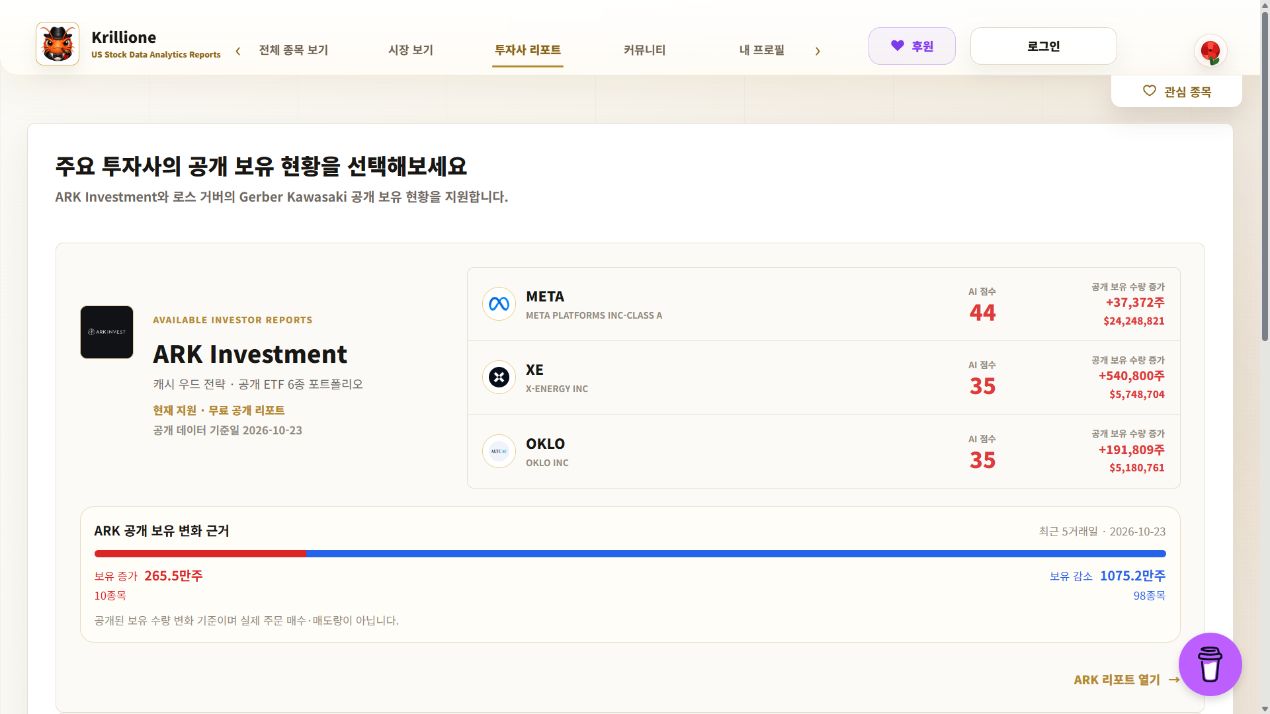
처음에는 수많은 정보를 한꺼번에 보여주자 결론과 상세 근거가 뒤섞였습니다. 이는 기존의 읽기 쉬운 보고서를 만들겠다는 취지에 맞지 않았습니다. 따라서 최대한 많은 정보를 뒤로 배치하면서 사용자가 시장→종목→리포트→기록 순서로 화면을 탐색하며 정보를 얻을 수 있도록 구성하였습니다.
사용자가 먼저 볼 간단한 정보와 더 들어가 정보를 읽을 수 있도록 보고서 형식으로 제시했습니다. 매일 업데이트 되는 AI 보고서는 깊은 정보를 품고 있습니다.
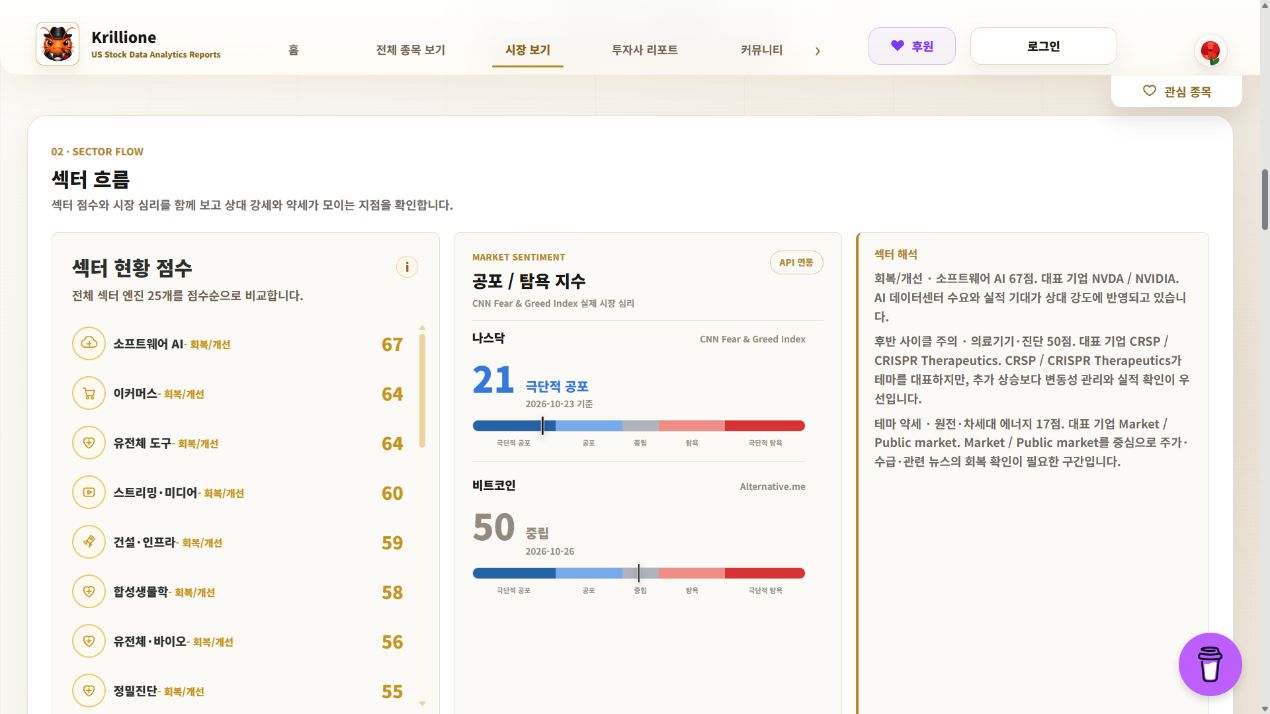
시장 보기
개별 종목을 보기 전에 시장 전체를 읽도록 지수·변동성·원자재·가상자산을 배치했습니다. 25개 섹터 점수와 공포·탐욕 지수로 분야별 흐름도 비교합니다.
TradingViewP2P 계약으로 나스닥100 선물 차트를 도입했습니다. 나스닥100 선물 차트에 직접 그림을 그리거나 여러 지표를 추가할 수 있으며 로그인을 통해 저장됩니다.FinancialJuice P2P 계약으로 실시간 거시 경제 뉴스를 도입했습니다. 따로 뉴스를 확인할 필요 없이 실시간으로 업데이트 되는 거시 경제 뉴스를 확인할 수 있습니다.
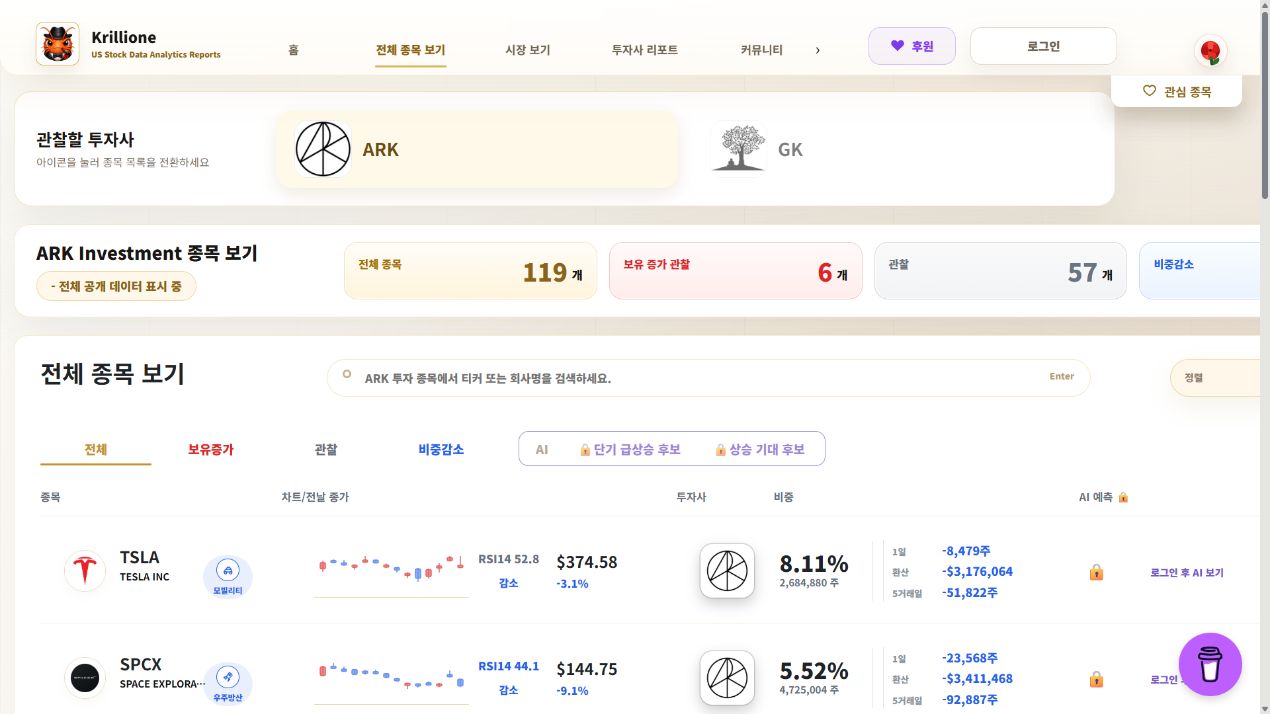
투자사 보유 변화·뉴스·실적 일정·예측 시장·FINRA ATS 거래량과 옵션 만기일의 거래량·미결제약정의 정보를 제공합니다.
투자사가 보유량을 늘린 종목을 발견해도 차트가 이미 과열됐는지, 기업에 악재가 있었는지까지 한 번에 확인하기는 어려웠습니다. 심지어는 투자사 또한 판단이 잘못되어서 강하게 매수하는 날에도 하락하는 경우가 드물게 발생하였습니다. 그래서 매일 공개 보유 자료와 시장 정보를 모으고, 종목마다 어떤 근거가 점수에 영향을 줬는지 백분율 점수로 한 눈에 볼 수 있는 구조를 만들었습니다.
전체 종목의 AI 점수와 추천 후보의 선별 기준은 구분했습니다. 종목을 비교할 때는 공통 점수를 보여주고, 후보를 고를 때는 단기 급상승과 상승에 각각 별도 조건을 적용했습니다.
점수 계산과 후보 선정
차트와 진입 시점, 종목 뉴스, ARK 보유 변화, 애널리스트 목표가, 업종 흐름을 각각 점수화했습니다. 주가가 올라 펀드 내 비중만 커진 경우는 주식 수가 늘어난 경우와 나누었습니다. 시장이 위험회피 국면이거나 종목이 과열됐을 때는 종합 점수에 상한을 뒀습니다.
단기 급상승 후보는 위축된 업종에서 회복하는 흐름과 강한 업종에서 아직 덜 오른 종목을 따로 살폈습니다. 상승 후보에는 투자사의 보유 증가 근거와 기업·업종 흐름이나 조정 후 회복 조건을 함께 요구했습니다. 매일 근거와 가격 기준일을 갱신하고, 편입과 종료는 이력에 남겼습니다.
기존 AI 점수에서 추천 이력까지
입력
투자사 보유 변화
보유 수량과 비중
종목·시장 자료
차트·뉴스·목표가·업종
판단
종합 점수
항목별 점수와 위험 상한
후보 선별
단기 급상승 / 상승
기록
추천 이력
추천일·기준가·관찰 최고가·종료가
전체 종목의 공통 점수와 후보별 선별 조건을 분리했습니다.
한계와 두 모델로의 전환
시장 위험회피를 점수에 반영했지만, 나스닥이 떨어질 때 높은 점수의 종목이 얼마나 버텼는지는 따로 확인해야 했습니다. 관찰 중 한 번 올랐더라도 종료 시점에는 하락할 수 있습니다. 그래서 관찰 중 최고가와 함께 종료 수익률, 하락폭, 시장 대비 움직임을 봐야 한다고 판단했습니다.
먼저 기관 보유 변화의 순서와 시장 반응으로 한 달(21거래일)과 석 달(63거래일)의 수익과 하방을 추정하는 이벤트 V2를 만들었습니다. 그 전망에서 산출한 점수에 최근 가격과 거래량을 더해, 지금 진입을 검토할 만한지를 따로 판단하는 단기 모델로 이어갔습니다.
02이벤트 모델 V2
왜 만들었는가
같은 보유 증가라도 앞선 감소를 되돌린 것과 여러 날 이어진 증가는 의미가 다를 수 있습니다. 저는 기관 행동을 점수 한 칸에 넣는 대신, 변화의 순서와 당시까지의 시장 반응을 학습할 수 있는 구조를 설계했습니다.
초기 사건 기억 모델은 3·10거래일 SPY 대비 초과수익을 예측했습니다. 종목이 하락해도 시장보다 덜 떨어지면 초과수익은 양수입니다. 후속 장기 모델은 21·63거래일의 종목 자체 수익, SPY 대비 초과수익, 하방 움직임을 따로 추정합니다.
데이터 수집
기관 보유 자료가 올라오면 원문을 모으고, 시장 자료는 마감된 거래일의 시세에 맞춥니다. 원본 기준일, 추정한 경제적 보유일, 실제 확보 시각을 따로 저장하여 분석합니다.
과거 ARK 아카이브는 SEC 보유 공시 표본과 대조했습니다. 예를 들어 두 자료를 같은 날짜로 맞췄을 때는 공통 식별자 1,010개 중 462개만 수량이 같았습니다. 다음 미국 거래일 기준으로 비교하니 공통 1,010개가 모두 일치했습니다. 과거 공개 시각의 지연 가정은 실제로 확보 시각을 기록한 전진 자료와 구분합니다.
수량 변화는 분할과 펀드 전체 유출입의 영향을 구분합니다. 보유 행이 빠졌을 때는 결측으로 남깁니다. 공개 보유량으로 확인할 수 있는 것은 잔고 변화까지입니다.
데이터 검증
2건
01
ARK 아카이브와 SEC의 날짜 기준을 맞췄습니다
같은 날짜 라벨로 맞춘 ARK·SEC 표본의 보유 수량이 서로 달랐습니다.
해결 기준
과거 ARK 자료에 시세와 기업행사를 붙이고, SEC 표본과 대조하도록 정했습니다. 과거 복구 자료와 실시간 관측은 분리했습니다.
바이브코딩으로 해결한 과정
Codex로 날짜를 같은 날과 다음 미국 거래일 기준으로 각각 대조했습니다. 아카이브 날짜와 경제적 보유일을 따로 저장하고, 과거 공개 시각의 지연 가정도 별도로 기록했습니다.
확인한 결과
표본 대조로 날짜를 하루씩 옮겨 검증했습니다. 양쪽에 각각만 있던 항목과 실제 과거 공개 시각은 별도로 미확인으로 남겼습니다.
2026.10.23 · 「논문 작성 방향 분석」 및 ARK 과거 보유 이력 실험
02
놓친 수집은 재개하고 성공분은 보존했습니다
일부 종목을 돌아가며 수집할 때 실행 간격을 늘리면 전체 확인이 늦어졌습니다.
해결 기준
자료가 올라오는 시점에 맞춰 전체를 수집하고, 실패한 항목만 다시 요청하도록 했습니다. PC가 꺼져 놓친 실행도 다음 로그인 때 보충하도록 정했습니다.
바이브코딩으로 해결한 과정
Codex로 펀드·종목별 성공 여부를 저장하고, 실패만 재시도하는 흐름을 구성했습니다. 이후 실행에서는 남은 자료와 해시·거래일을 다시 확인합니다.
확인한 결과
한 실행에서 요청한 보유 자료 7개와 시세 21개를 모두 확보했습니다. 이후에도 성공·실패와 누락 여부를 실행별로 점검합니다.
2026.11.06 · 「기관 이벤트 수집 주기 찾기」 및 기관 이벤트 수집 완료 기록
모델 설계
초기에는 보유 변화마다 기억을 만들고, 유보·같은 방향·반대 방향 반응을 유지·수정 상태와 결합했습니다. 사건을 펀드로 모으고 다시 운용사 단위로 묶었습니다.
이벤트 모델 V2는 ARK 6개 펀드의 누적 보유 변화와 시장 특징을 각각 인코딩한 뒤, 시장 맥락에 따라 기관 특징을 얼마나 반영할지 학습합니다. 최근 3거래일의 상대 거래량, 증가 흐름, 기울기도 시장 입력에 넣었습니다.
매 거래일 새 기관 자료와 완료 시세로 같은 학습 가중치에서 전망을 갱신합니다. 당시 입력과 예측은 보존합니다. V2가 추정한 21·63거래일 절대수익, SPY 대비 초과수익, 하방 위험은 뒤의 단기 모델에서 가점을 계산하는 데도 사용합니다.
입력 실험
1건
01
거래량을 학습 입력으로 살렸습니다
3거래일 거래량이 급증해도 이미 주가가 올라 있거나 변동성이 크면 같은 의미로 볼 수 없습니다.
해결 기준
최근 거래량을 모델 판단에 반영하도록 요청했습니다. 실제 영향과 성능은 고정된 비교 조건에서 확인했습니다.
26,355행 중 47행은 결측 표시로 남았습니다. 63일 초과수익 추정이 거래량 입력 후 높아진 행과 낮아진 행을 모두 확인했습니다. 평가 오차 개선은 확인하지 못했습니다.
2026.11.04 · 「논문 작성 방향 분석」 및 장기 V2 거래량 학습 보고서
이벤트 모델 · 장기 V2
입력
기관 누적 108열
1·5·21·63거래일 보유 변화
시장 25열
가격·위험·최근 거래량 3개 특징
결합
기관·시장 인코더
각각 24차원으로 변환
가중 결합
시장 맥락에 따라 기관 특징 조절
출력
절대·초과수익
종목 자체 수익과 SPY 대비 수익
하방 움직임
진입 후 불리한 가격 움직임
133개 입력과 결측 표시를 사용합니다. 21·63거래일마다 수익과 하방을 함께 출력합니다.
초기 3·10거래일 사건 기억 모델
입력
기관 특징 8개
수량·비중·시점·마스크
시장 특징 16개
가격·거래량·마스크
표현
사건 인코더
변화별 기억 생성
시장 GRU
과거 가격 문맥
기억
반전 처리
같은 펀드·종목
6개 상태
유지·수정 × 반응 3종
통합
사건 주의집중
사건 → 펀드
운용사 통합
내부 → 운용사 간
출력
기억 + 시장 문맥
상대 수익률·방향
과거 20거래일 입력으로 SPY 대비 초과수익과 방향을 예측한 초기 구조입니다.
학습과 검증
기존 ARK 보유 이력과 시세로 V2 학습을 마쳤습니다. 시간순으로 학습 17,070건과 검증 3,800건을 나눴고, 이전 실험에 사용한 2026년 상반기 2,370건에서 모의 평가를 진행했습니다.
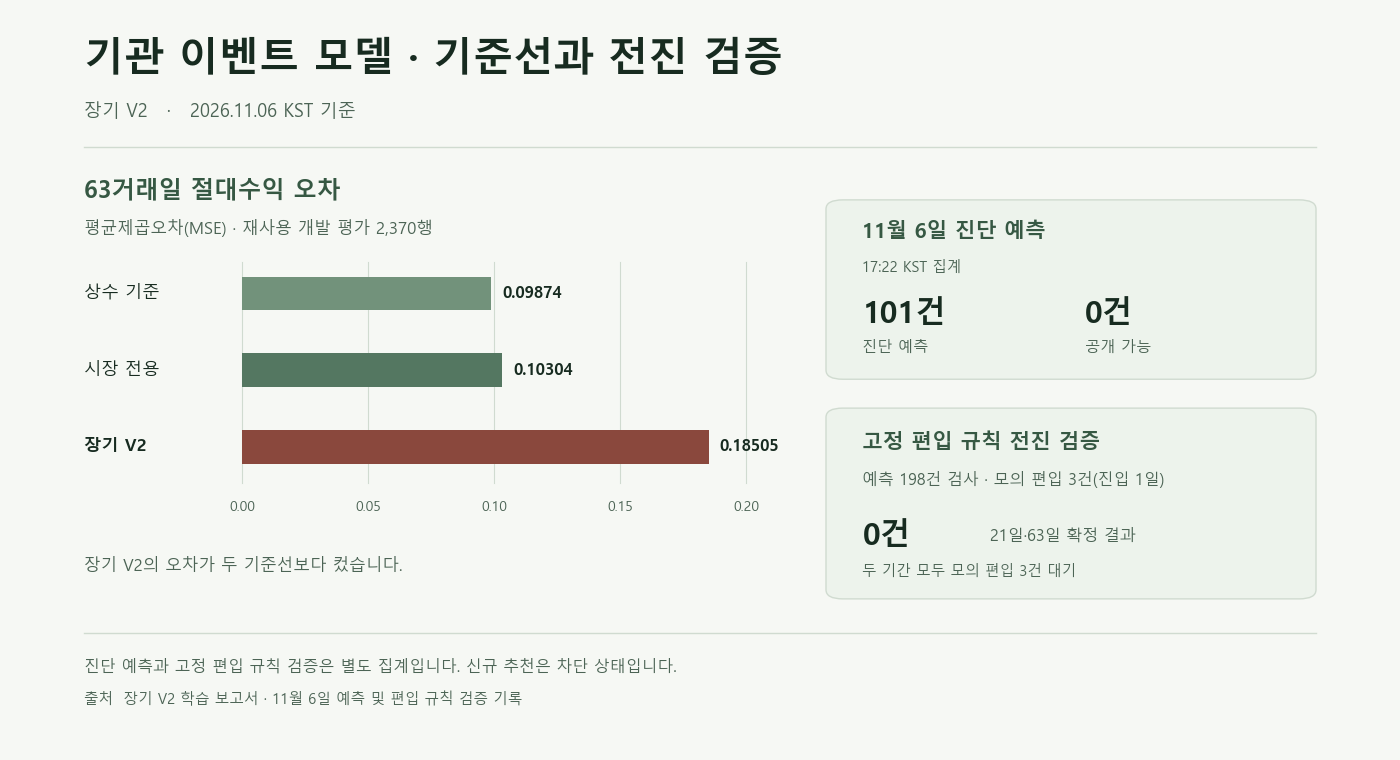
63거래일 뒤 수익이 양수인지 맞힌 비율은 52.03%였습니다. 날짜별 예상 수익 상위 3종목을 뽑은 모의 선별에서는 왕복 비용 1%를 빼고 75건 중 28건(37.33%)의 수익이 양수였습니다. 63거래일 절대수익 오차(MSE)는 V2가 0.18505로, 상수 기준 0.09874와 시장 전용 0.10304보다 컸습니다.
매 거래일 새 예측을 고정해 두고 21·63거래일이 지나면 실제 수익과 하락폭을 연결합니다. 2027년 초부터 새 데이터의 63거래일 결과를 확인할 예정입니다. 두 기간 모두 서로 다른 진입일 20일 이상의 성과가 확보되면 비용 후 수익과 하방을 비교해 검증을 마칠 계획입니다.
전진 검증
1건
01
학습 완료와 추천 자격을 분리했습니다
학습 오차가 줄어도 새 기간의 성과를 보장하지 않습니다. 이미 확인한 구간의 성과를 다시 독립 검증처럼 해석할 수 있습니다.
해결 기준
새 추천은 미사용 기간에서 거래비용과 하방 위험까지 검증한 뒤에만 열도록 정했습니다. 과거 재현과 실제 전진 검증은 별도로 집계합니다.
바이브코딩으로 해결한 과정
Codex로 동일 입력의 기준선과 시장 전용 모델을 비교하고, 분할 경계에 겹치는 결과를 제거했습니다. 추천 검증에는 왕복 비용 1%, 하방 한도, 서로 다른 진입일 수를 기록하도록 했습니다.
확인한 결과
과거 모의 평가에서 V2는 사전에 정한 오차 기준에 미달했습니다. 새로 고정한 예측의 21·63거래일 결과가 쌓이면 같은 기준으로 다시 확인합니다.
2026.11.04~06 · 장기 V2 학습 보고서와 진단·편입 원장
운영 검증
1건
02
이력이 맞지 않을 때 마지막 검증 집계를 유지했습니다
성과 집계와 추천 이력의 식별자가 맞지 않으면 다른 추천의 결과가 붙거나 같은 기록이 두 번 집계될 수 있습니다.
해결 기준
이력과 성과가 같은 기록으로 연결된 경우에만 최신 집계로 교체하도록 했습니다.
바이브코딩으로 해결한 과정
Codex로 입력 이력과 성과의 연결을 확인하고, 전송하는 집계의 접근 권한과 재전송 중복 방지를 검수했습니다.
확인한 결과
과거 이력 43건의 연결을 재확인해야 했던 검수에서는 교체를 보류하고 직전 검증 집계 118건을 유지했습니다.
2026.11.06 11:35 KST · 크릴리오네 모델 구성 및 검증 보고서
V2 과거 모의 평가 · 2026년 상반기 재사용 자료
기간
수익 방향 정확도
상위 3종목 모의 선별 · 비용 후 수익 양수
21거래일
56.96% (1,350 / 2,370건)
44.00% (33 / 75건)
63거래일
52.03% (1,233 / 2,370건)
37.33% (28 / 75건)
이벤트 모델 · 진단과 공개 편입 검증
추론
고정 V2와 최신 자료
21·63일 절대·초과수익과 하방 추정
모의 편입
기관 증가 근거와 전망 개선
같은 기준집단에서 점수 개선 확인
비용·위험 필터
왕복 비용 1% 차감 후 절대·초과수익 양수 · 예상 하방 10%/15% 이내
성과 확정
실제 전진 원장
21·63일 각각 완료된 결과를 별도로 보존
공개 심사
두 기간 확정 진입일 최소 20일 · 평균 순절대·초과수익 양수 · 하방 한도 초과율 25% 이하
제가 확인하고 싶은 것은 기관이 보유량을 바꾸는 순서와 강도를 알면, 가격과 거래량만으로 판단할 때보다 이후 움직임을 더 잘 설명할 수 있는가입니다. 같은 시점과 종목에서 기관 입력을 쓴 V2와 시장 전용 모델을 비교합니다.
예측을 먼저 저장하고 이후 21·63거래일 결과를 연결합니다. 어느 시장 국면에서 기관 정보가 도움이 됐고 어디에서 빗나갔는지, 데이터가 없었던 경우까지 정리해 논문으로 발전시킬 수 있는지 검토하고 있습니다.
03단기 상승 요건 추적 모델
왜 만들었는가
이벤트 V2의 모의 검증을 보면서 전망이 좋더라도 언제 진입할지는 별도로 판단해야 한다고 봤습니다. 그래서 V2 전망에서 산출한 점수에 현재 가격 위치, 거래량과 하방 조건을 더했습니다. 크릴리오네에 올라오는 ARK·GK 종목을 매 거래일 같은 기준으로 비교합니다.
일일 실행에서 신규 후보를 선별하고 주간 누적을 확인합니다. 후보는 하루 0~3개, 주간 0~5개입니다. 조건을 만족하는 종목이 없으면 빈 목록을 그대로 기록합니다.
데이터 수집
같은 게시 시점의 종목 목록에서 중복을 정리하고, 종목과 SPY의 날짜가 맞는 연속 23개 완료 일봉을 확인합니다. 최근 3개 봉과 그 앞 20개 봉을 나누면 비교 기준에 현재 거래량이 섞이지 않습니다.
미국 거래소·USD 가격·마감 여부를 확인합니다. 수정주가의 조정계수가 크게 달라진 구간은 기업행사를 확인할 수 있도록 보류합니다. 기관 보유 근거가 있는 경우 원문과 실제 관측 시점을 확인합니다.
개장 전 확보한 자료로 가격 조건까지 평가할 수 있는 종목을 매일 확인합니다. 한 실행에서는 종목·시세 식별자 132개 중 119개의 가격 조건을 평가했습니다. 나머지는 확보 시각, 일봉 누락, 기업행사 등 보류 사유를 남겼습니다.
데이터 검증
1건
01
과거에 볼 수 있었던 종목과 가격으로만 비교했습니다
오늘의 종목 목록이나 뒤늦게 받은 일봉으로 과거를 재현하면 당시 판단할 수 없었던 정보를 사용하게 됩니다.
해결 기준
개장 전에 확보한 게시본과 시세를 사용하고, 출처나 가격이 맞지 않으면 보류하도록 정했습니다.
바이브코딩으로 해결한 과정
Codex로 게시본의 버전, 종목·SPY의 거래일, 시세 확보 시각을 검사하는 단계를 만들었습니다. 당시 게시본이 없는 날은 평가 불가로 따로 기록합니다.
확인한 결과
당일 입력과 사후 복원 자료를 분리했습니다. 같은 조건을 다시 검증할 때에도 당시 종목 목록과 평가 가능 여부를 확인할 수 있습니다.
2026.11.05 · 단기 진입 신호 일일 검수 기록
모델 설계
20거래일 고점을 저항선으로 삼고, 그 아래에서 거래량이 쌓이거나 막 돌파한 종목을 찾습니다. 최근 3거래일 평균 거래량은 직전 20거래일 평균의 1.30배 이상이어야 합니다. 돌파 뒤 허용 범위는 고점 위 3%입니다.
SPY 대비 상대강도 또는 확인된 기관 보유 증가에 가격 흐름, 최소 거래대금과 하방 7% 조건을 함께 봅니다. 진입 요건을 충족하면 근거 점수는 최대 85점입니다. 같은 진입일의 V2 전망이 21·63거래일 비용·위험 기준을 통과하면, 21거래일 예상 순초과수익의 순위로 최대 15점을 더합니다.
이번 비교에서는 저항선 아래 접근 폭만 3%와 5%로 바꿨습니다. 거래량·돌파 상한과 일 0~3건·주 0~5건 기준은 두 규칙에 동일하게 적용합니다. 같은 입력을 다시 실행해도 그날 처음 확정한 기록을 유지합니다.
판단 기준
1건
01
V2 전망과 단기 진입 조건을 함께 판단했습니다
V2의 21·63거래일 전망으로는 오늘의 가격이 이미 과열됐는지, 돌파를 뒷받침하는 거래량이 있는지 알기 어려웠습니다.
해결 기준
가격과 거래량으로 진입을 검토하고, 같은 진입일의 V2 전망이 비용·위험 조건을 통과할 때 순위에 가점을 반영했습니다.
바이브코딩으로 해결한 과정
Codex로 같은 후보군에서 진입 근거만 쓴 목록과 V2 가점을 더한 목록을 만들었습니다. 두 목록에 같은 편입 상한을 적용해 점수가 실제 선별을 바꾸는지 확인합니다.
확인한 결과
첫 비교에서 네 조합 모두 진입 조건을 통과한 후보가 없었습니다. 후보가 없었던 날도 기록하고, 이후 양쪽의 편입과 실제 가격을 비교합니다.
단기 V2 가점 전진 비교 원장
전진 검증
1건
02
저항선 접근 범위만 넓혀 비교했습니다
저항선과 거래량 조건을 함께 만족하는 후보가 드물었습니다. 거래량 기준만 낮춘 과거 재현에서는 하방 한도를 넘는 사례가 생겼습니다.
해결 기준
거래량 1.30배와 편입 한도는 유지하고 저항선 아래 접근 폭만 3%에서 5%로 넓힌 안을 병행하도록 정했습니다. 공개 추천은 검증을 통과할 때까지 차단했습니다.
바이브코딩으로 해결한 과정
Codex로 같은 개장 전 배치를 두 규칙에 적용하고, 진입일별 첫 유효 결과를 해시와 함께 보존하도록 구현했습니다. 5거래일 순수익과 보유 중 최대 하락폭을 각각 집계합니다.
확인한 결과
같은 개장 전 배치로 두 규칙을 나란히 실행했습니다. 모의 편입이 없었던 날도 결과를 저장하고, 두 규칙의 성과를 비교할 수 있도록 편입 이후의 가격을 계속 모읍니다.
기존 모델에서 남긴 단기 급상승·상승 추천 이력으로 먼저 확인했습니다. 2026년 11월 4일에 보존한 크릴리오네 운영본에서, 9월 8일~10월 30일에 추천되고 종료가 확인된 51건을 집계했습니다. 두 유형에 겹친 추천은 원장의 한 건으로 계산했습니다.
관찰 중 상승 확인 비율은 82.4%(42/51건)였습니다. 원장에 저장된 관찰 최고가가 각 추천의 기준가를 한 번이라도 넘은 경우입니다. 종료 수익률은 기록이 있는 48건 중 20건(41.7%)이 양수였습니다. 예를 들어 ILMN은 관찰 중 최대 +16.42%였지만 종료 기록은 -0.43%였습니다.
현재는 매 거래일 개장 전 같은 자료로 저항선 접근 폭 3%와 5%를 비교하고, 각각 V2 가점을 넣은 경우와 뺀 경우를 기록합니다. 편입 후 3·5·10거래일 가격이 쌓이면 비용 차감 후 수익과 하락폭을 확인합니다. 아래 표는 기존 추천 원장 집계입니다.
비교 실험
1건
01
AI 가점이 실제 후보를 바꾸는지 확인했습니다
가점을 붙여 점수가 달라져도 후보나 성과가 달라지는지는 따로 확인해야 했습니다.
해결 기준
같은 날에 같은 수집 근거를 적용하고, AI 가점을 넣은 경우와 뺀 경우의 3·5·10거래일 성과를 비교하도록 정했습니다.
바이브코딩으로 해결한 과정
Codex로 두 집단에 같은 비용과 위험 조건을 적용하는 재현을 만들었습니다. 진입일 단위로 후보 구성과 비용 차감 후 수익 차이를 비교했습니다.
확인한 결과
과거 재현의 한 비교에서는 가점이 붙은 종목이 한 개였지만 편입 종목은 바뀌지 않았습니다. 실제 후보 구성과 수익이 달라지는지는 같은 방식으로 계속 확인합니다.
가정용 CCTV의 움직임 감지 기능을 Wi-Fi로 대신할 수 있는지 탐구한 졸업작품입니다. 두 강의실에서 CSI를 수집하고, 인원수 분류와 보행 감지 모델을 자체·외부 데이터로 검증했습니다.
5인 팀 · 장비·수집·전처리·모델 실험·검증 참여 2026년 7~10월 · 팀 졸업 연구 · 결과 정리 Python · PyTorch · Intel 5300 · CSI
카메라 없이 집 안의 움직임을 알 수 있을까
집을 지키기 위해 설치한 카메라가 사생활을 드러내는 통로가 되기도 합니다. 2025년 12월 경찰청은 국내 IP카메라 약 12만 대를 해킹해 영상을 탈취한 사건을 발표했습니다. 보안 해킹 우려가 폭증하는 가운데 CCTV를 대체할 수단의 필요성이 부각되고 있는 상황입니다. 우리는 집에 이미 설치된 Wi-Fi로 실내 변화를 읽고, 홈 CCTV의 움직임 감지 기능을 영상 촬영 없이 구현할 수 있는지 실험했습니다.
CSI(Channel State Information, 채널 상태 정보)는 수신기가 Wi-Fi 패킷의 피지컬 데이터를 이용해 추정한 물리 계층의 채널 신호입니다. 송수신 링크와 부반송파 그룹마다 신호의 진폭과 위상이 얼마나 달라졌는지를 복소수로 기록한 것이 바로 CSI입니다.
수신기에는 직접 도착한 전파와 벽·가구·사람에 반사되거나 산란·회절된 전파가 겹쳐 들어옵니다. 사람이 움직이면 이 경로들의 합이 바뀌고, 그 변화가 시간에 따른 CSI 패턴으로 나타납니다. 모델이 이 패턴을 학습하면 화면 없이도 인원이나 보행을 구분할 수 있지 않을까 하는 가능성을 파악하고자 했습니다.
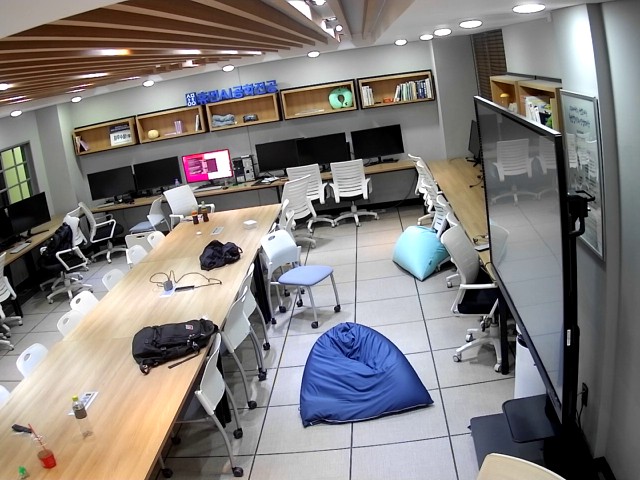
송신·수신 PC에 Intel Wi-Fi Link 5300 카드와 안테나 3개씩을 연결했습니다. 안테나 간격과 방향을 매 수집시마다 일정하게 맞추기 위해 3D 프린팅 거치대를 사용했습니다. 두 PC가 같은 2.4 GHz 휴대폰 핫스팟에 접속하고, 수신 PC는 핫스팟에서 들어오는 Wi-Fi 프레임의 CSI를 측정했습니다.
수신 PC는 Ubuntu 18.04.6 LTS의 Linux 4.15 커널에서 수정한 iwlwifi 드라이버와 펌웨어를 사용했습니다. connector_log=1로 CSI 로그를 켠 뒤, 송신 PC의 safe_sender.py가 512바이트 UDP 패킷을 초당 100개씩 보내도록 설정했습니다. 수신 PC의 log_to_file이 CSI를 DAT 파일에 저장하면, 파일과 실제 CSI 레코드가 함께 기록됐는지 확인했습니다.
수신 PC의 실행기에서 강의실, 장비 배치, 고정 인원·자유 활동 중 수집 방식, 인원수, 행동, 수집 시간, 웹캠 사용 여부를 지정했습니다. 필요한 회차에는 참가자의 자리와 행동별 시간·반복 횟수, 빈 방 기준 세션을 함께 기록했습니다.
빈 방은 0명 기준으로 수집했습니다. 빈 방을 수집하는 이유는 공간에 대한 학습이 필요하기 때문입니다. 인원을 고정한 실험에서는 앉기·서기·교대 걷기를 순서대로 안내하기도 했습니다. 별도 자유 활동 실험에서는 약 40분 동안 출입과 움직임의 순서를 정하지 않고 기록했습니다.
실험 장비와 패킷 흐름
송신
송신 PC
Intel 5300 · 안테나 3개 · UDP 100패킷/초
중계
휴대폰 핫스팟
2.4 GHz Wi-Fi로 수신 PC에 전달
기록
수신 PC
Intel 5300 · 안테나 3개 · Linux CSI Tool
웹캠
같은 실험을 촬영해 행동 라벨에 사용
송신 PC는 실험용 트래픽을 만들고, 수신 PC는 핫스팟에서 도착한 프레임의 채널 응답을 기록했습니다.
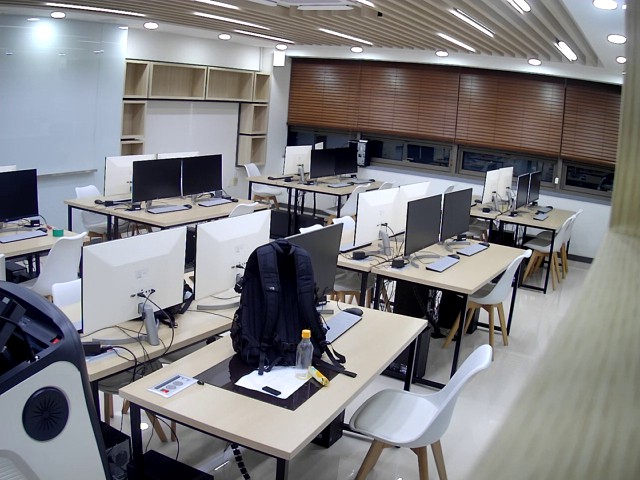
G304 강의실 · 실제 수집 영상 프레임G308 강의실 · 실제 수집 영상 프레임
두 강의실에서 모은 CSI와 모델 입력
가구와 장비 배치가 다른 G304·G308 강의실에서 반복 수집해, 환경이 바뀌었을 때도 동일한 모델이 준수한 성능을 기록하는지 비교하고자 했습니다. G304에서는 0~5명, G308에서는 0~4명 조건을 기록했습니다.
수집 이력 31개 중 데이터가 남은 원본 DAT 22개에서 CSI 레코드 1,417,202개를 확인했습니다. 파일별 첫 기록부터 마지막 기록까지 합산하면 약 4시간 53분입니다. 이 가운데 고정 인원 학습 후보는 15개 세션, 약 3시간 46분이었고, 약 40분의 자유 활동 세션을 기록하여 모델 테스트 용으로 분리했습니다.
CSI의 형태는 수신 안테나 3개 × 송신 공간 스트림 2개 × 부반송파 그룹 30개였습니다. 학습 후보에서 실제 관측률은 초당 약 70~87개였습니다. 초기 인원수 모델은 6개 링크의 수신 안테나 순서를 복원하고 진폭을 보정한 뒤, 100 Hz 시간 격자에서 비중첩 2초 구간을 만들었습니다.
수집 및 전처리 단계별 데이터 규모
범위
세션·파일
CSI 관측 시간
레코드·입력 구간
기록이 남은 전체 원본
DAT 22개
약 4시간 53분
레코드 1,417,202개
고정 인원 학습 후보
15개 세션
약 3시간 46분
레코드 1,102,726개
자유 활동 시험 후보
1개 세션
약 40분
레코드 190,409개
초기 인원수 모델 입력
14개 세션
전처리 후 구간 선별
2초 구간 5,716개
동시 촬영 영상에서 행동 라벨로
CSI를 받는 동안 웹캠으로 같은 공간을 촬영했고, 원본 영상을 인원수 및 보행 라벨링에 사용했습니다.
초 단위 영상 프레임을 검토해 빈 방, 앉아 있거나 제자리에 서 있는 구간은 정적(S), 사람이 분명히 걷는 구간은 보행(D)으로 분류했습니다. 가림·암전으로 행동을 확인하기 어려운 구간은 제외했습니다. 영상과 CSI의 시간차를 추정한 뒤 같은 행동 라벨 안에 온전히 들어오는 2초 구간 4,344개를 남겼습니다.
YOLO v8n을 실행해 화면 속 사람을 탐지하고 위치를 표시했습니다. 보행 라벨은 시간대별 영상 검토를 거쳐 확정했고, CSI 모델에는 정렬한 라벨을 정답으로, Wi-Fi CSI를 입력으로 사용했습니다.
초기에는 Person-in-WiFi의 구조를 참고한 U-Net 계열 모델로 0~5명 분류를 시험했습니다. 같은 수집 회차의 특징을 외우는지 확인하기 위해 세션 단위로 데이터를 나눴고, 이후 인원 구간과 정적·보행을 별도 과제로 다뤘습니다. 모델 설계·검증에서는 CSI만으로 학습한 모델들이 두 강의실에서 보행을 얼마나 잘 구분했는지 비교합니다.
데이터에서 모델 과제로
과제
정답
모델 입력
인원수 분류
수집 메타데이터의 0~5명
CSI 구간
인원 구간 분류
정해진 인원 범주
CSI 구간의 특징
정적·보행 감지
영상 검토 후 CSI에 맞춘 S / D 라벨
CSI의 진폭·위상 변화와 시간 문맥
01두 논문에서 두 과제로
Person-in-WiFi와 DensePose From WiFi
Person-in-WiFi (ICCV 2019)는 연속된 CSI 표본을 2차원 특징 지도로 펼친 뒤, 잔차 합성곱과 U-Net을 통해 신체 윤곽과 관절 위치·연결을 추정했습니다. 카메라에서 얻은 정답으로 학습하고, 추론에는 Wi-Fi 신호를 넣었습니다.
DensePose From WiFi는 진폭과 보정된 위상을 따로 인코딩한 뒤 결합해, 신체 24개 영역의 표면 좌표까지 추정했습니다. 같은 배치의 평균 정밀도(AP) 43.5가 학습하지 않은 배치에서는 27.3으로 떨어졌고, 세 명 이상이 동시에 등장하면 개인별 신호를 분리하기 어려웠다고 보고했습니다.
우리는 DensePose From WiFi를 선행 연구로 검토하고, 실제 기준 모델은 Person-in-WiFi의 공간 변환과 잔차 합성곱·U-Net을 응용해 처음부터 학습했습니다. 수집 장비에서 나온 6개 링크의 진폭을 5시점씩 읽어 96×96 특징 지도로 변환하고, 단일 U-Net과 전역 평균 풀링 뒤에 0~5명 분류기를 붙였습니다. 2초 구간은 짧은 입력 조각들의 분류 확률을 평균해 판단했습니다.
초기 U-Net은 원본 녹화가 겹치지 않도록 나눈 14세션·5,716구간에서 개발 정확도 22.97%를 기록했습니다. 별도로 남긴 자유 활동 녹화에서는 66/1,024구간(6.45%)을 맞혔습니다. 실제 인원이 2~4명이던 자유 활동 평가에서 예측의 56.74%가 5명으로 몰렸습니다.
별도 통계 분류기의 진단에서도 같은 세션을 섞어 나누면 98.31%, 세션 하나를 통째로 빼면 17.28%였습니다. 한 번의 녹화에서 잘 맞는 특징이 새 녹화의 인원수까지 설명하지 못했습니다. 강의실, 날짜, 채널, 배치가 인원 조건과 함께 바뀐 회차가 있어 어떤 요인이 오류를 일으켰는지 따로 가려내기 어려웠습니다.
같은 네 사람도 앉아 있을 때와 걸을 때 신호가 달라집니다. 반대로 빈 방과 사람이 가만히 있는 방에서는 둘 다 시간에 따른 변화가 작을 수 있습니다. 몇 명이 있는가와 누군가 걷고 있는가는 서로 다른 질문입니다. 인원은 방별 진폭 특징으로 범주를 추정하고, 보행은 진폭·위상 변화와 직전 흐름으로 판별하도록 나눴습니다.
02인원수 범주 모델
강의실별 CSI로 0명·1~2명·3명 이상 분류
발표에 사용한 인원 모델의 출력은 0명·1~2명·3명 이상입니다. 각 강의실에 맞춰 모델을 따로 학습했습니다. 2초의 CSI 진폭을 보정하고 64 Hz로 재표본화한 뒤, 6개 링크와 30개 부반송파 그룹에서 시간 변동·링크별 통계·부반송파별 평균 등 265개 특징을 계산했습니다. 학습 데이터로 정한 10~90백분위 범위로 특징을 스케일링하고, RBF SVM으로 세 범주의 경계를 학습했습니다.
인원 조건별 자료를 시간순으로 나눠 앞 80%로 학습하고 뒤 20%를 시험했으며, 경계 전후 15초는 제외했습니다. G304는 510/596구간(85.57%), G308은 521/521구간(100%)을 맞혔습니다. 같은 원본 녹화의 앞뒤가 학습과 시험에 들어갈 수 있으므로 이 수치는 해당 강의실과 수집 조건에서의 분류 결과입니다.
G304에서는 실제 3명 구간 140개 중 81개(57.86%)만 3명 이상으로 맞혔습니다. 3명 이상 전체 결과보다 경계에 걸친 3명 조건의 오류가 컸습니다.
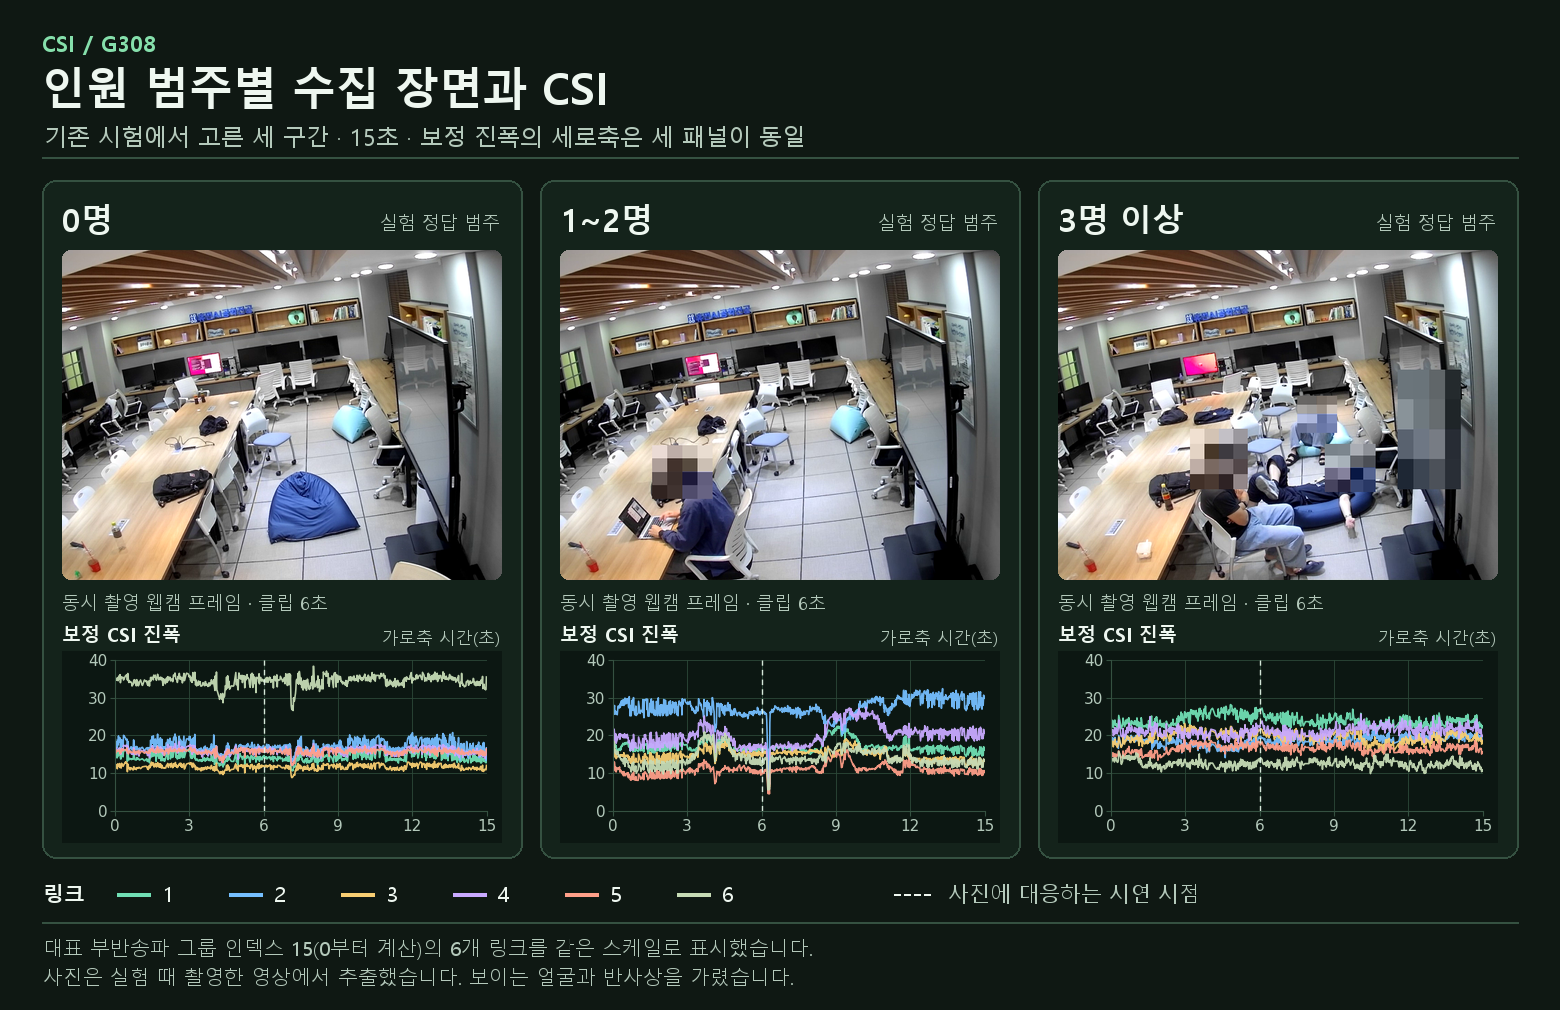
아래 그림은 G308에서 고른 세 인원 범주의 수집 영상과 같은 시간대의 실측 CSI입니다. 6번 링크는 0명 예시에서 가장 높았고, 2번 링크는 1~2명 예시에서 가장 높았습니다. 인원 범주가 바뀔 때 링크마다 진폭의 변화 방향이 달랐습니다. 모델은 30개 부반송파 그룹의 여러 특징을 함께 사용합니다.
인원 범주별 정답 수 / 시험 구간
실제 인원 범주
G304
G308
0명
59 / 59
105 / 105
1~2명
123 / 145
212 / 212
3명 이상
328 / 392
204 / 204
전체
510 / 596 · 85.57%
521 / 521 · 100%
인원 범주 모델의 입력과 출력
입력
2초 CSI 진폭
6개 링크 × 30개 부반송파 그룹 · 64 Hz
특징
진폭 특징 265개
전체 변동 · 링크 통계 · 부반송파별 평균
분류
G304 전용 RBF SVM
0명 · 1~2명 · 3명 이상
G308 전용 RBF SVM
0명 · 1~2명 · 3명 이상
강의실을 지정해 해당 방에서 학습한 스케일러와 분류기를 사용했습니다.
G308 인원 범주별 수집 장면과 실측 CSI
03정적·보행 모델
왜 주판단기와 보조판단기를 나눴나
보행은 2초 구간의 경계에 걸치기도 합니다. G304의 문맥 실험에서는 현재 2초만 보면 보행 8/12구간, 직전 문맥을 더하면 9/12구간을 찾았습니다. 정적 오경보는 두 경우 모두 3/202구간이었습니다. 현재 구간의 변화가 약해도 직전에 이어지던 보행이 판별의 근거가 될 수 있었습니다.
주판단기는 6개 링크의 진폭·위상이 100 ms 사이에 얼마나 바뀌는지 계산한 뒤, 현재 2초를 MLP와 여러 시간 폭의 1차원 CNN으로 읽습니다. 보조판단기는 같은 CSI 인코더로 현재와 직전 2초·4초 구간을 각각 읽고, 구간 사이의 특징 차이까지 묶어 최대 6초의 흐름에서 보행을 다시 확인합니다.
직전 문맥을 포함한 판정은 다른 방에서 오경보를 늘리기도 했습니다. G304 V2를 G308에 바로 적용했을 때 주경로와 주·보조 결합은 모두 보행 4/5구간을 찾았지만, 정적 오경보는 22/302에서 39/302로 늘었습니다. 보조 경로의 보행 후보를 다시 걸러야 했습니다.
V5에서는 기존 두 경로를 고정하고, 두 점수·이력 유무·물리 특징 24개를 입력받는 482개 파라미터의 보정기를 학습했습니다. V6에서는 보행 후보를 정적으로 뒤집으려는 상황에서 이력이 부족하거나 경계에 가까우면 판단 보류(U)를 반환하는 규칙을 추가했습니다. 같은 V6 모델과 규칙을 두 강의실에 적용했습니다.
V6 정적·보행 판단 흐름
입력
2초 CSI 변화
진폭·위상 100 ms 차분 · 100 Hz · 결측 마스크
판단
주판단기
현재 2초 · MLP + 다중 스케일 1D CNN · 128 → 64 → 2
보조판단기
현재·직전 2초·4초 · 특징 차이를 묶어 640 → 64 → 2
재검사
공통 보정기
두 점수 + 이력 유무 + 물리 특징 24개 · 27 → 16 → 2
출력
S 정적
분명한 보행 없음
D 보행
분명한 실내 이동
U 판단 보류
보행 취소 판단의 경계·이력 부족
V6의 보류 규칙은 V5 보정기의 가중치를 유지한 채 추가했습니다.
같은 4인 녹화에서 정적과 보행 비교
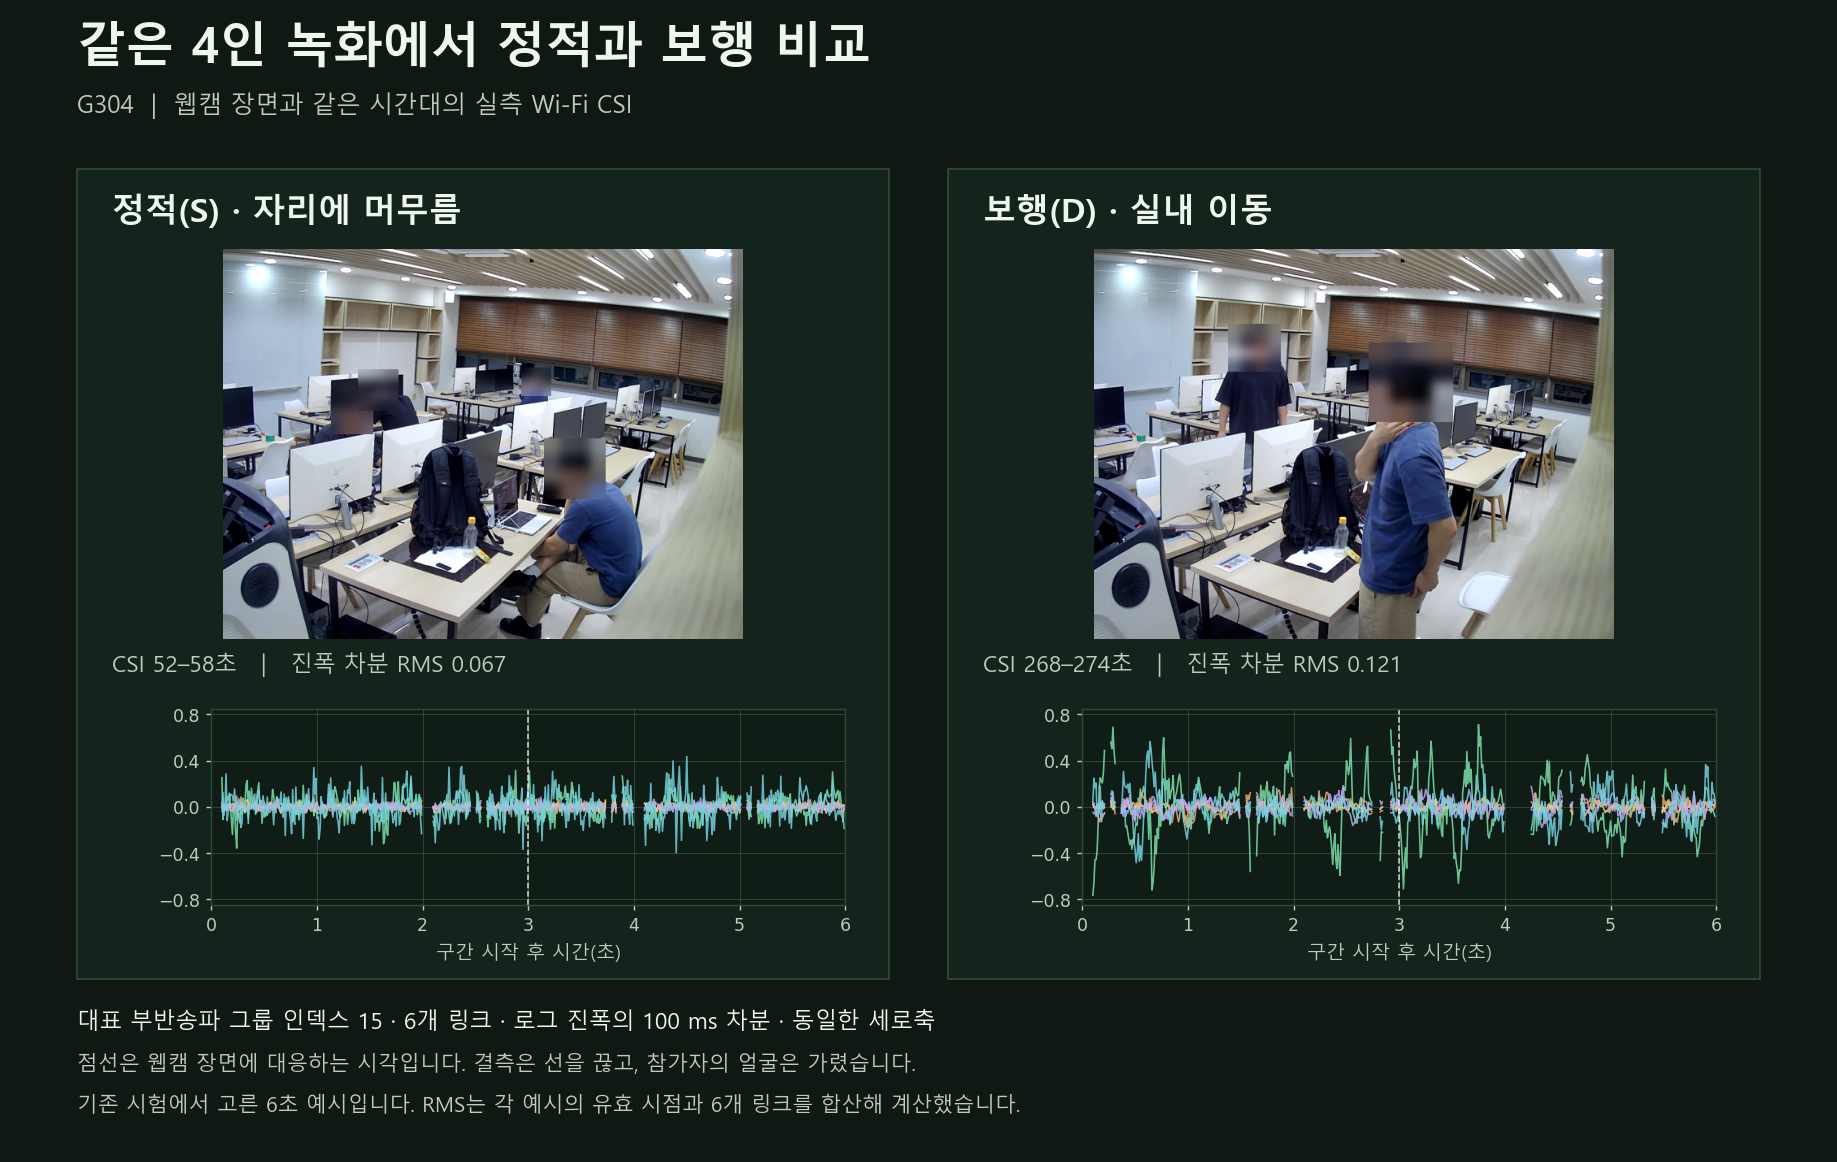
그림은 같은 G304 4인 녹화에서 골랐습니다. 자리에 머문 6초와 실제로 걸은 6초의 웹캠 장면, 그리고 대표 부반송파 그룹의 6개 링크를 한 눈금에 놓았습니다. 유효 시점의 로그 진폭 차분 RMS는 정적 0.067, 보행 0.121로, 이 두 예시에서는 보행 구간의 변화가 컸습니다. 표의 성능은 전체 기존 시험 구간에서 계산했습니다.
공통 V6는 G304에서 보행 9/12구간(75%), G308에서 4/5구간(80%)을 검출했습니다. G308의 동일한 307개 구간에서 G304 V2를 바로 적용했을 때와 비교하면, 보행 검출 4/5는 유지하면서 정적 오경보가 39건에서 9건으로 줄었습니다. G304에서는 비교군이 맞혔던 보행 한 구간을 더 놓쳤습니다.
G304는 날짜를 분리했고, G308은 같은 원본 녹화 안에서 학습과 시험 구간을 나눴습니다. G308은 모두 정적으로 분류해도 전체 정확도가 98.37%인 시험입니다. 그래서 보행 검출률·정적 오경보율·전체 보류율을 함께 봤고, 보류한 보행도 검출률의 분모에 넣었습니다.
공통 V6 기존 시험 · 각 구간 2초
평가
G304
G308
보행 검출
9 / 12 · 75.00%
4 / 5 · 80.00%
정적 오경보
0 / 202 · 0.00%
9 / 302 · 2.98%
전체 보류
1 / 214 · 0.47%
8 / 307 · 2.61%
G304 같은 4인 녹화의 정적·보행 장면과 실측 CSI
04기대와 한계
방과 장비가 바뀌면 무엇이 무너졌나
다른 장비의 데이터에서도 동작하는지 보기 위해 공개 EHUNAM의 단일 링크 입력을 기존 모델 형식에 맞췄습니다. 가중치와 정규화를 고정한 상태로 주 수신기 47,510구간을 평가했습니다. 동적 검출은 7,010/33,098구간(21.18%)이었고 정적 오경보율은 0.32%, 보류율은 1.67%였습니다.
외부 자료의 동적에는 기계 작동도 포함됩니다. 자체 자료의 동적은 사람의 보행입니다. 링크 수와 장비, 공간, 정답의 의미가 함께 달라졌으므로 검출 저하의 원인을 하나로 특정하기 어렵습니다. 가중치를 그대로 옮기는 방식으로는 안정적인 외부 감지가 어려웠습니다.
자체 시험에도 놓친 보행이 남았습니다. G304에서 보행을 놓친 한 2초 구간의 대표 링크 묶음 RMS는 0.115로, 검출한 보행 시연의 0.121에 가까웠습니다. G308에서 놓친 보행은 직전의 연속 구간이 없어 보조판단기에 충분한 이력을 줄 수 없었습니다. 변화량이 큰 보행도 놓칠 수 있고, 보조 경로의 도움은 연속 기록을 확보할 수 있는지에 달려 있었습니다.
카메라 없이 어디까지 감지할 수 있나
이번 실험에서 기대할 수 있는 것은 공간을 촬영하지 않고 빈 방 여부나 뚜렷한 보행을 확인하는 감지 기능입니다. 장비와 배치가 정해진 공간에서는 인원 범주를 보조 정보로 쓸 가능성도 봤습니다. 감지 단계에서 영상 입력을 빼면 집 안의 일상을 촬영하는 부담을 줄일 수 있습니다.
가장 아쉬웠던 점은 같은 녹화에서는 높던 점수가 새 회차에선 크게 떨어졌다는 것입니다. 2초 구간을 많이 만들어도 서로 같은 방·채널·배치에서 이어진 관측입니다. 인원수마다 독립 녹화가 적은 상태에서는 모델이 사람 수와 함께 나타난 세션의 특징을 외우기 쉬웠습니다. 보행 시험도 G304 12구간, G308 5구간이어서 한 구간의 오답이 검출률을 크게 바꿉니다.
다시 실험한다면 같은 방과 장비에서 인원수·자리·행동을 번갈아 바꿔 반복 수집하고, 방이나 채널을 바꿀 때는 다른 조건을 고정해 비교하겠습니다. 새 날짜와 새 방에서 모은 원본 회차를 별도 시험으로 남겨, 정적 오경보와 놓친 보행, 판단 보류를 함께 보겠습니다. 그래야 집을 촬영하지 않고도 필요한 변화를 얼마나 꾸준히 포착하는지 판단할 수 있습니다.
선별한 실험 결과
G304 보행 검출 · V6: 9 / 12 구간 2026년 10월 19일. 같은 원본의 인접 구간이며 새 환경의 일반화 수치가 아닙니다.
G308 보행 검출 · V6: 4 / 5 구간 작은 보행 표본입니다. 정적 오경보·보류와 함께 봐야 합니다.
현재 상태와 다음 과제
자체 보행 표본이 작고 연구 중 반복 관찰한 시험 자료가 포함됩니다.
EHUNAM에서는 일반화 목표에 미치지 못했습니다. 장비·링크·동적 라벨이 다릅니다.
현재 결과는 정적·보행 감지이며 범용 인원수 추정·자세 복원은 미완입니다.
03 / GAME · SIMULATION
주막
AI로 만든 메뉴를, 내 주막에서.
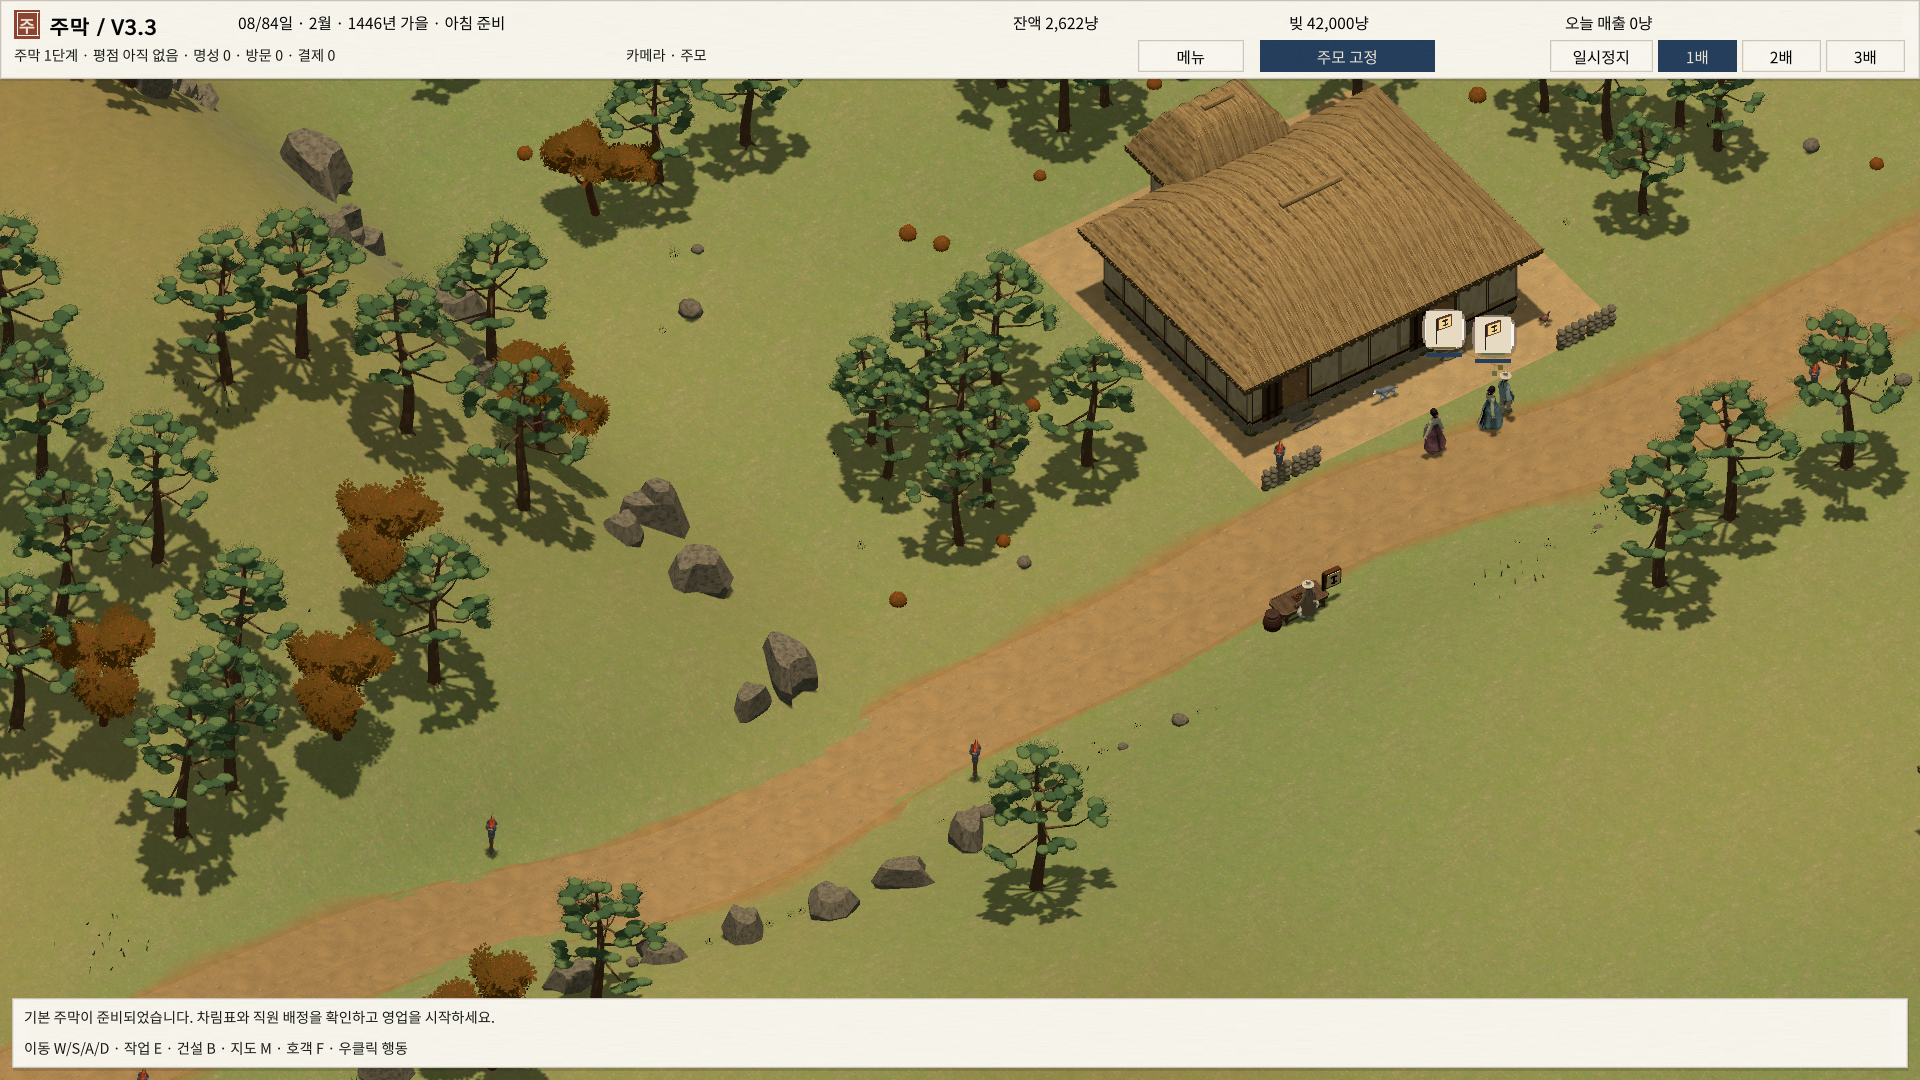
AI로 메뉴를 만들고 주막에서 판매·공유하는 경영 게임을 기획했습니다. 현재 운영 프로토타입을 개발하고 AI 제작 도구와 커뮤니티를 설계하고 있습니다.
1인 기획·개발 2026년 중순 ~ 현재 · 게임 프로토타입 개발 · AI 서비스 설계 Unity · C# · Simulation
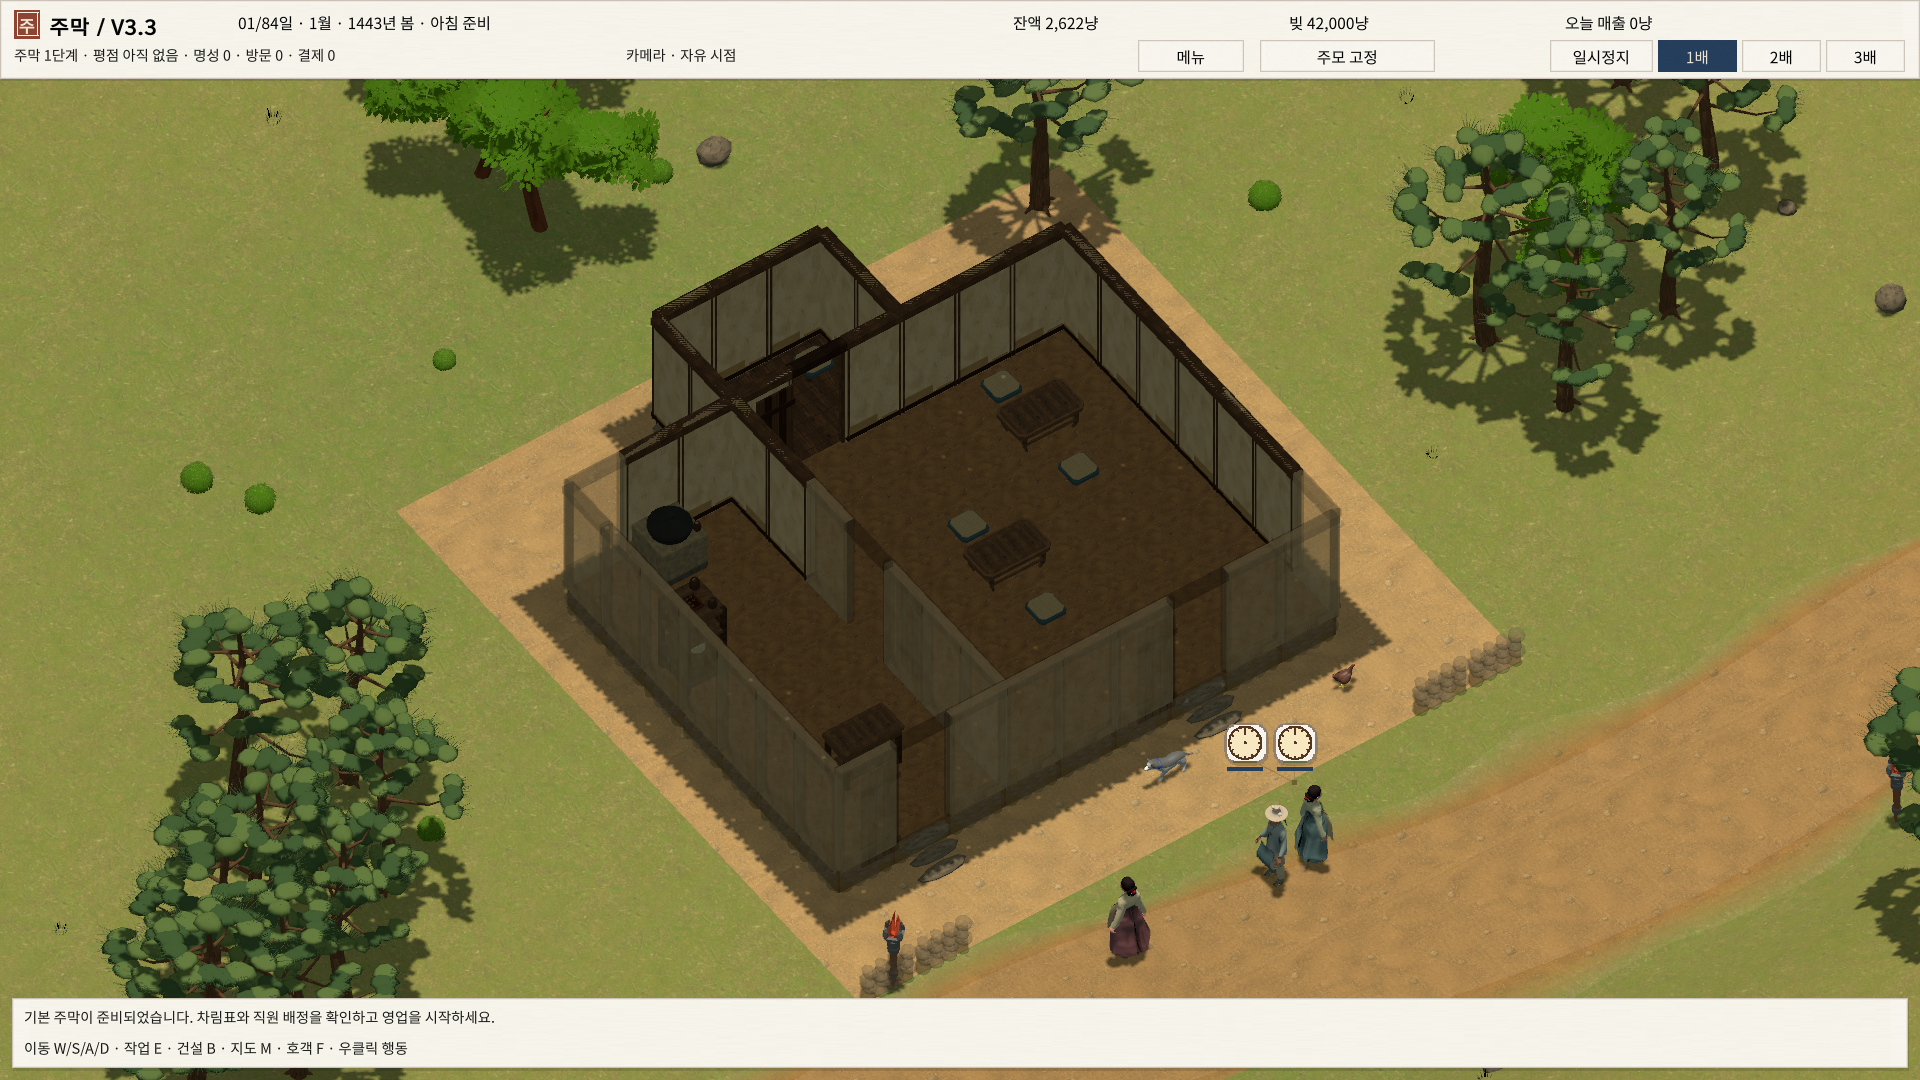
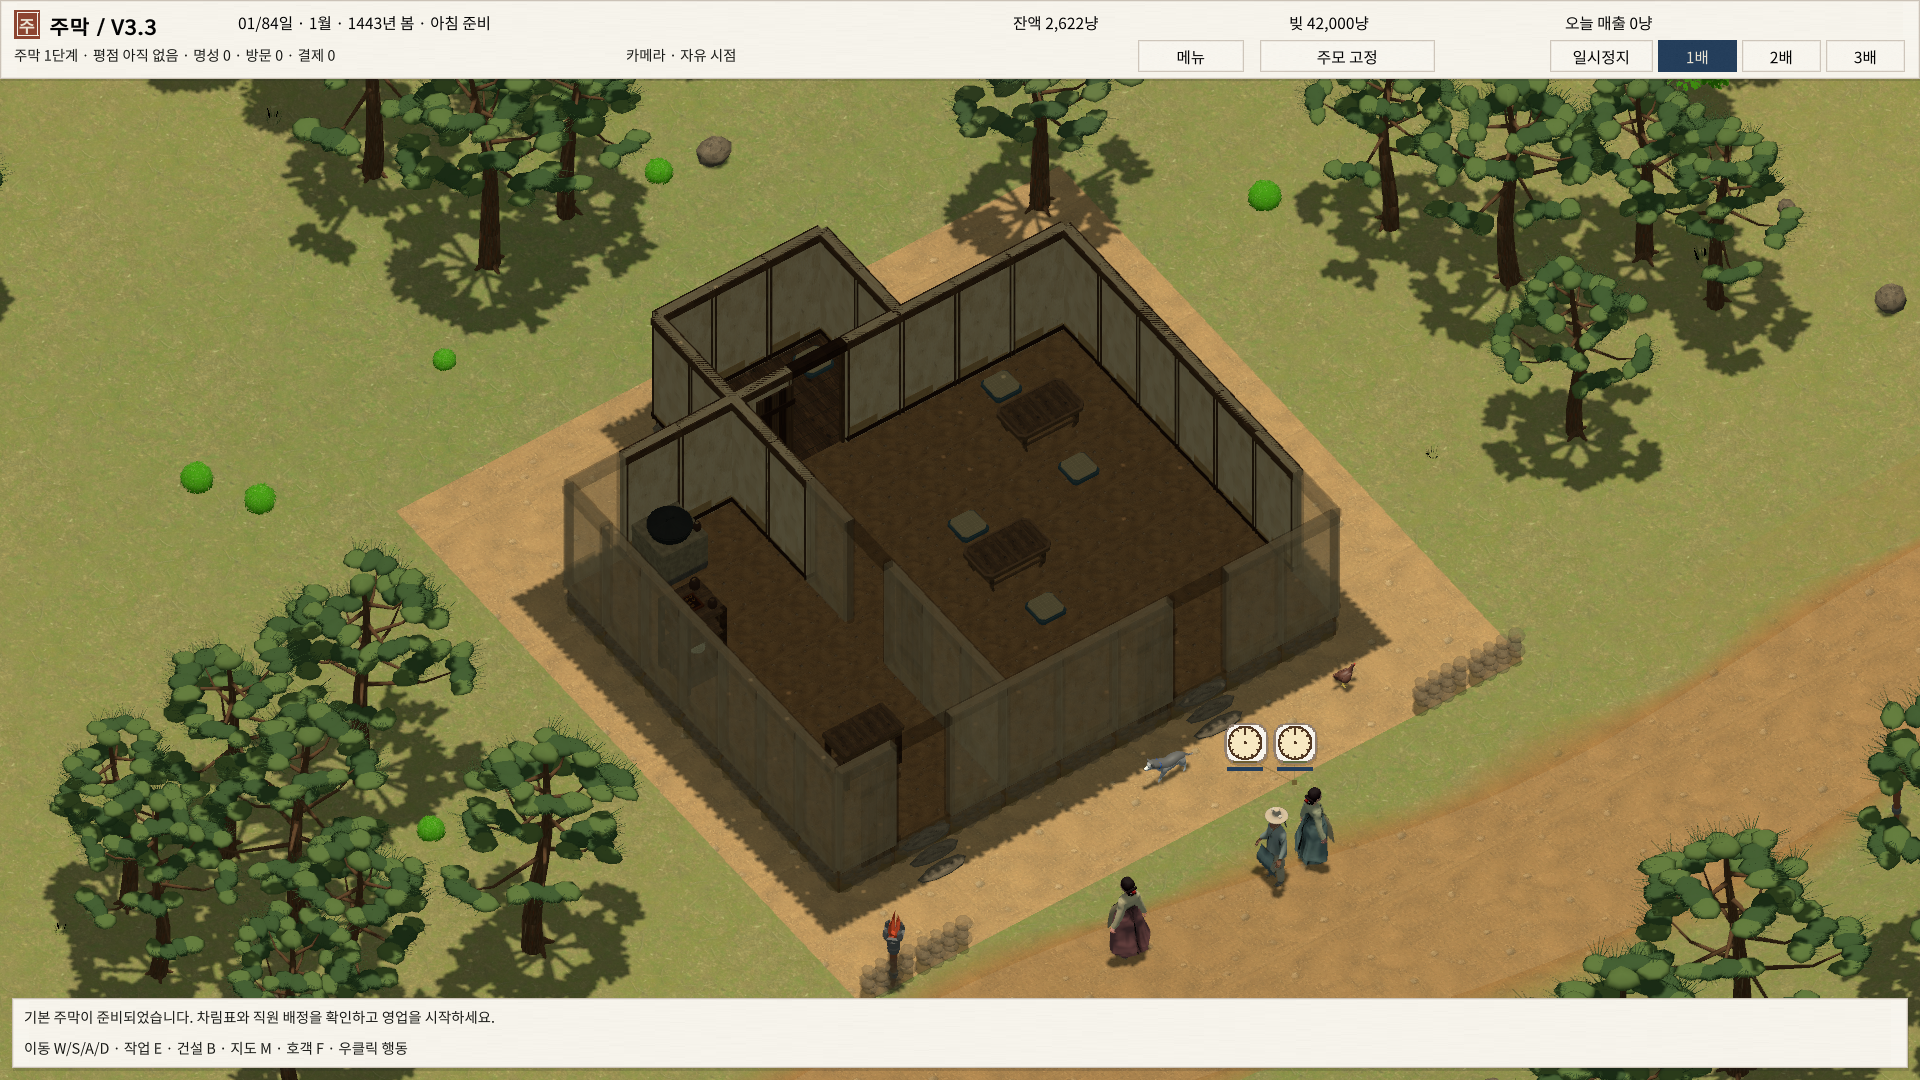
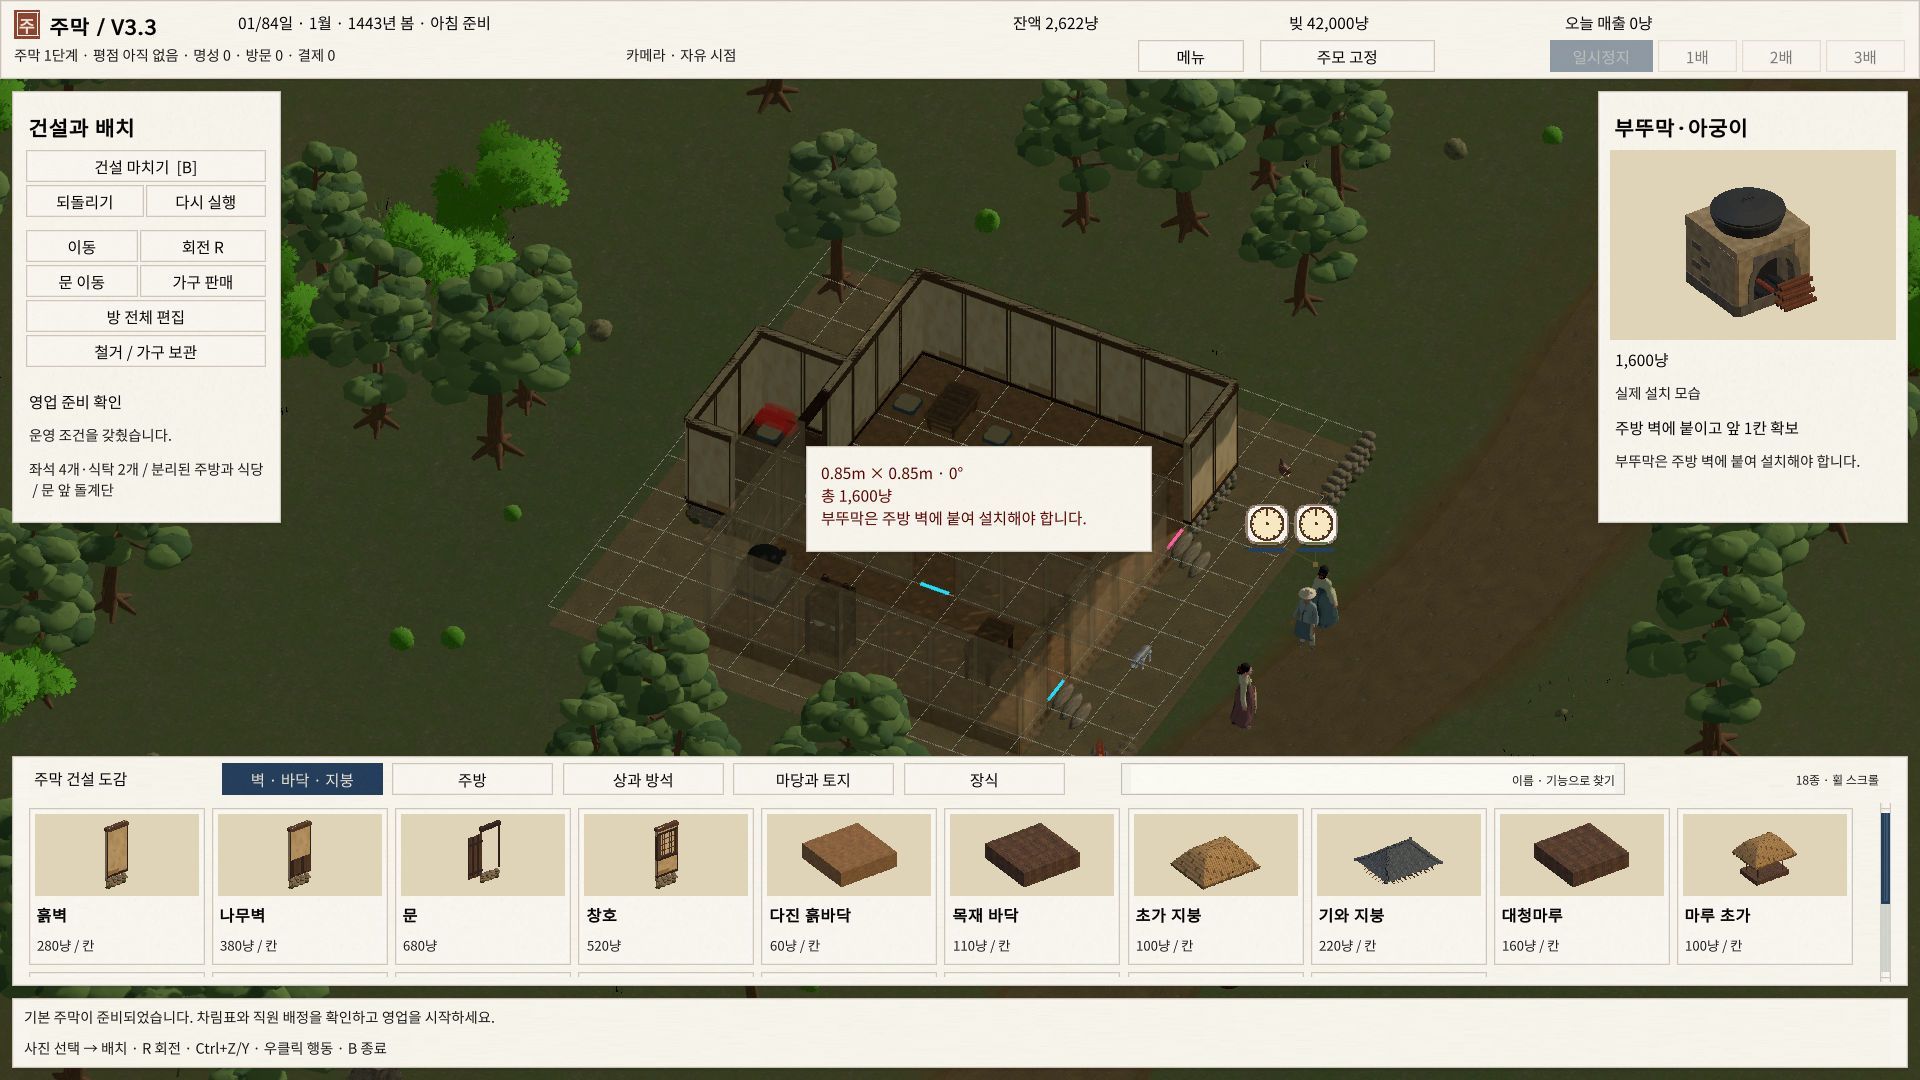
주막의 영업 공간
AI로 나만의 메뉴 만들기
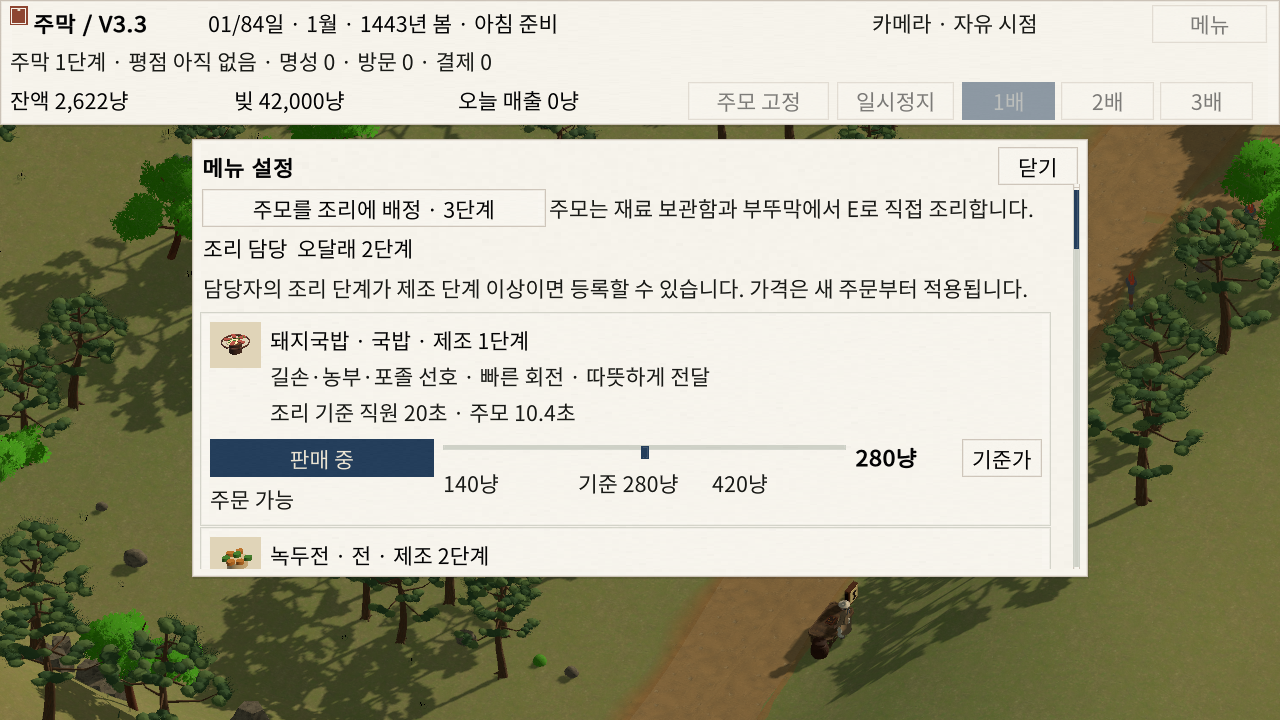
국밥의 그릇과 술병의 모양에도 플레이어의 취향이 담기길 바랐습니다. 자신이 만든 메뉴를 손님에게 팔 때 창작이 경영의 일부가 된다고 생각했습니다.
심즈 4·시티즈 스카이라인의 사용자 콘텐츠 커뮤니티를 참고했습니다. AI 메쉬 생성으로 제작의 진입 장벽을 낮추고, 제작·판매·공유를 잇는 서비스를 기획했습니다.
주막 내부와 영업 공간
메뉴 제작 도구
플레이어가 술·국밥·전을 고르고 재료와 그릇을 설명하는 도구를 기획했습니다. 꽃무늬 사발의 국밥처럼 자기 취향에서 제작을 시작합니다.
Meshy로 메쉬와 텍스처를 생성하고, 형태를 확인하며 수정하도록 설계했습니다. 크기·재질·용량을 게임 규격에 맞춘 뒤 메뉴명과 분류를 연결해 판매할 계획입니다.